Deep Learning
Introdução, Fundamentos e Aplicações
Prof. Dr. Raphael Teixeira
Deep Learning
Baseado no Capítulo 1 — The Deep Learning Revolution — de:
C. M. Bishop & H. Bishop, Deep Learning: Foundations and Concepts , Springer, 2024.
Roteiro do capítulo:
O impacto do Deep Learning — quatro exemplosExemplo tutorial — ajuste de curva polinomialBreve história do aprendizado de máquina
1.1 O impacto do Deep Learning
Machine learning: soluções aprendidas a partir de dados substituem algoritmos feitos à mão
Deep learning : redes neurais profundas — o framework mais geral e poderoso de ML hojeMesmo framework resolve problemas de domínios completamente diferentes
Supervisionado dados rotulados \(\to\) prevê rótulo/valor
Não supervisionado dados sem rótulo \(\to\) aprende estrutura
Auto-supervisionado rótulos extraídos automaticamente dos próprios dados
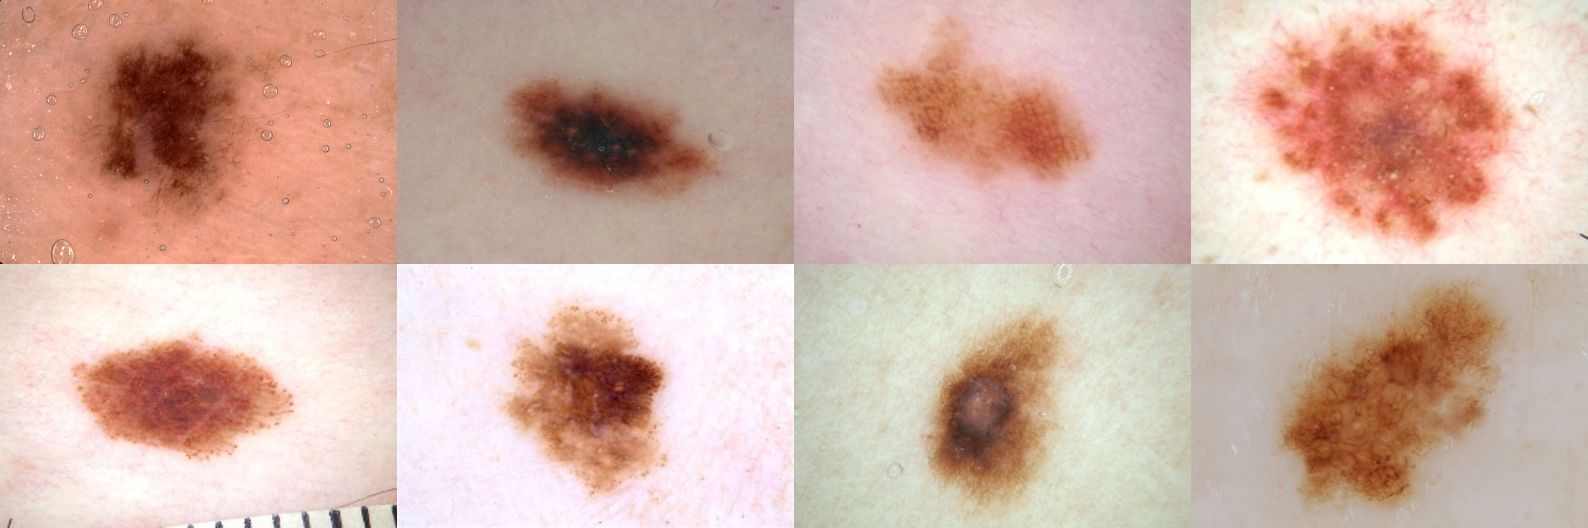
Diagnóstico médico
Melanomas malignos (topo) vs. nevos benignos (base)
Classificar lesão de pele: maligna ou benigna
Rede treinada com ~129 mil imagens rotuladas (biópsia = verdade)
~25 milhões de pesos ajustáveis
Exemplo de classificação supervisionada
Transfer learning : pré-treino em 1,28M imagens genéricas \(\to\) fine-tuning nas lesões
Acurácia superior à de dermatologistas profissionais.
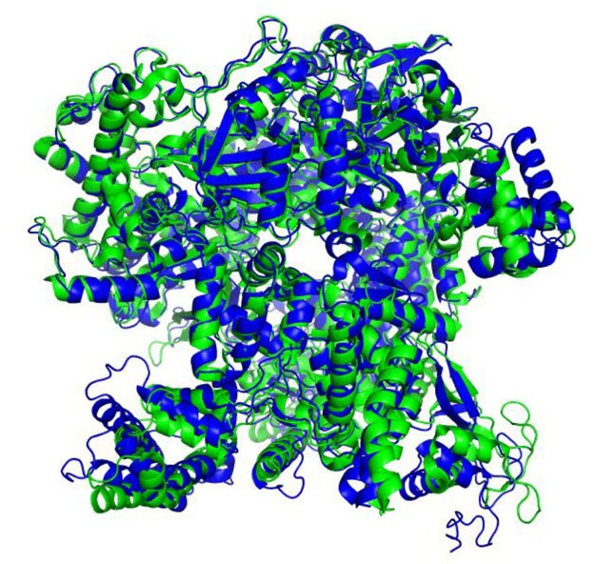
Estrutura de proteínas
Prever a forma 3D de uma proteína a partir da sequência de aminoácidos
Problema em aberto há 50 anos
AlphaFold (Jumper et al., 2021)Também é aprendizado supervisionado : pares (sequência, estrutura 3D conhecida)
Verde: estrutura real (raio-X). Azul: predição do AlphaFold.
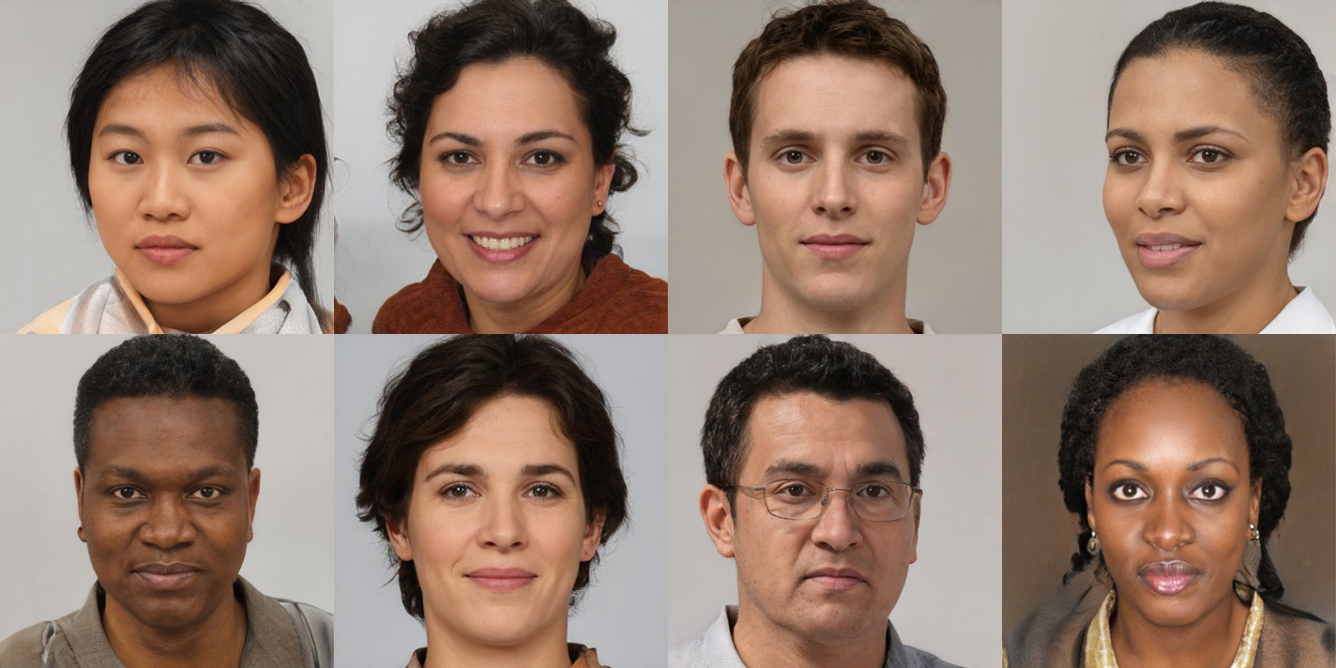
Síntese de imagens
Rostos sintéticos — nenhuma dessas pessoas existe
Dados de treino: apenas imagens, sem rótulos
Exemplo de aprendizado não supervisionado
Modelo generativo : gera novos exemplos plausíveisCondicionado a texto \(\to\) IA generativa (imagem, vídeo, áudio, texto, moléculas…)
Modelos de linguagem (LLMs)
Constroem representações internas do significado da linguagem
Autorregressivos : preveem a próxima palavra dado o texto anteriorA sequência gerada realimenta o modelo \(\to\) gera a próxima, e a próxima…
Treino: auto-supervisionado — o “rótulo” é a próxima palavra do próprio texto
Permite escalar para volumes massivos de dados sem rotulagem humana
GPT-4 já foi descrito como uma primeira manifestação de inteligência artificial geral (Bubeck et al., 2023).
1.2 Exemplo tutorial: ajuste de curva
Problema clássico de regressão (supervisionado):
Variável de entrada \(x\) , variável alvo \(t\) , ambas contínuas
Dado um conjunto de treino \(\{(x_n, t_n)\}_{n=1}^N\) , prever \(t\) para um novo \(x\)
Capacidade de acertar dados nunca vistos = generalização
import numpy as npimport matplotlib.pyplot as plt42 )= 10 = np.linspace(0 , 1 , N)= np.linspace(0 , 1 , 200 )= np.random.normal(0 , 0.25 , N)= np.sin(2 * np.pi * x) + noise # dados = seno + ruído gaussiano
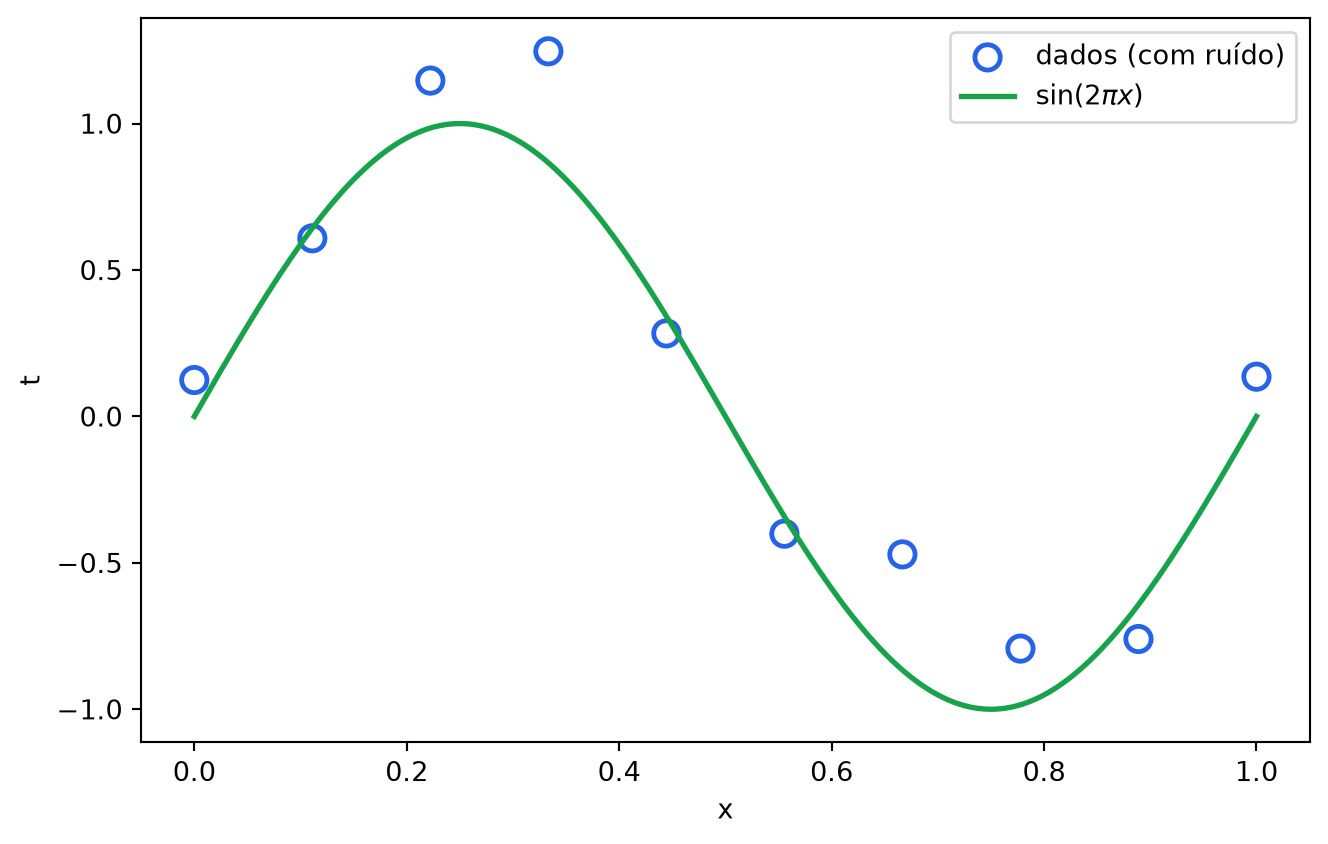
Dados sintéticos
A função verde é desconhecida na prática — o objetivo é descobri-la a partir dos pontos azuis.
Modelo linear (nos parâmetros)
Ajuste por polinômio de grau \(M\) :
\[y(x, \mathbf{w}) = w_0 + w_1 x + w_2 x^2 + \ldots + w_M x^M = \sum_{j=0}^M w_j x^j\]
Não linear em \(x\) , mas linear nos coeficientes \(\mathbf{w}\)
Funções lineares nos parâmetros \(\to\) modelos lineares
def MatrizRegressao(x, M):= len (x)= np.zeros((n, M + 1 ))for j in range (M + 1 ):= x** jreturn X
Função de erro
Mede o desajuste entre o modelo e os dados — soma dos quadrados dos resíduos:
\[E(\mathbf{w}) = \frac{1}{2} \sum_{n=1}^N \{y(x_n, \mathbf{w}) - t_n\}^2\]
\(E(\mathbf{w})\) é quadrática em \(\mathbf{w}\) \(\to\) mínimo único, solução fechada \(\mathbf{w}^\star\) Resolvida com mínimos quadrados: \(\mathbf{w}^\star = (\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T\mathbf{t}\)
def MinimosQuadrados(X, t, lam= 0.0 ):= X.T @ X + lam * np.eye(X.shape[1 ])return np.linalg.solve(XtX, X.T @ t)
Sub-ajuste vs. sobre-ajuste
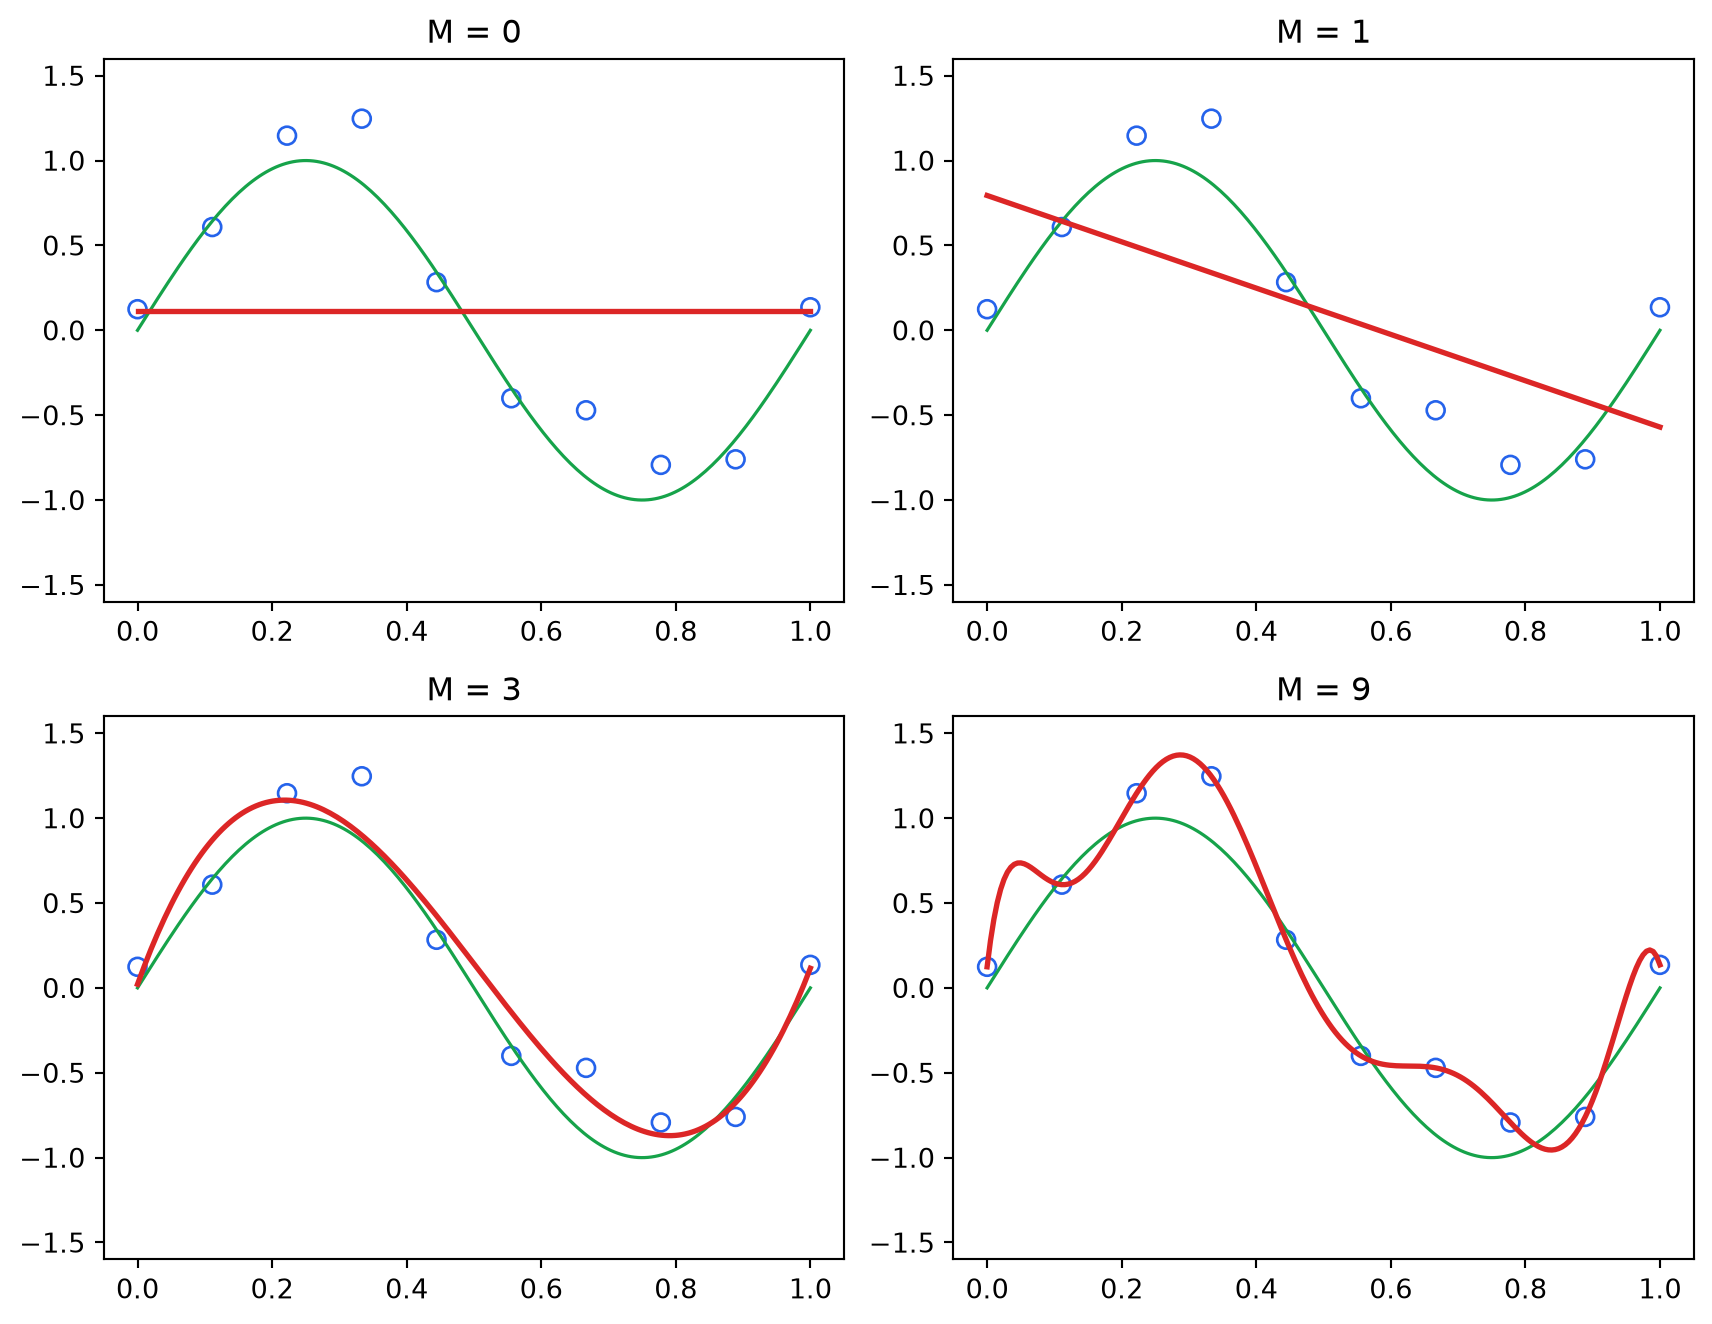
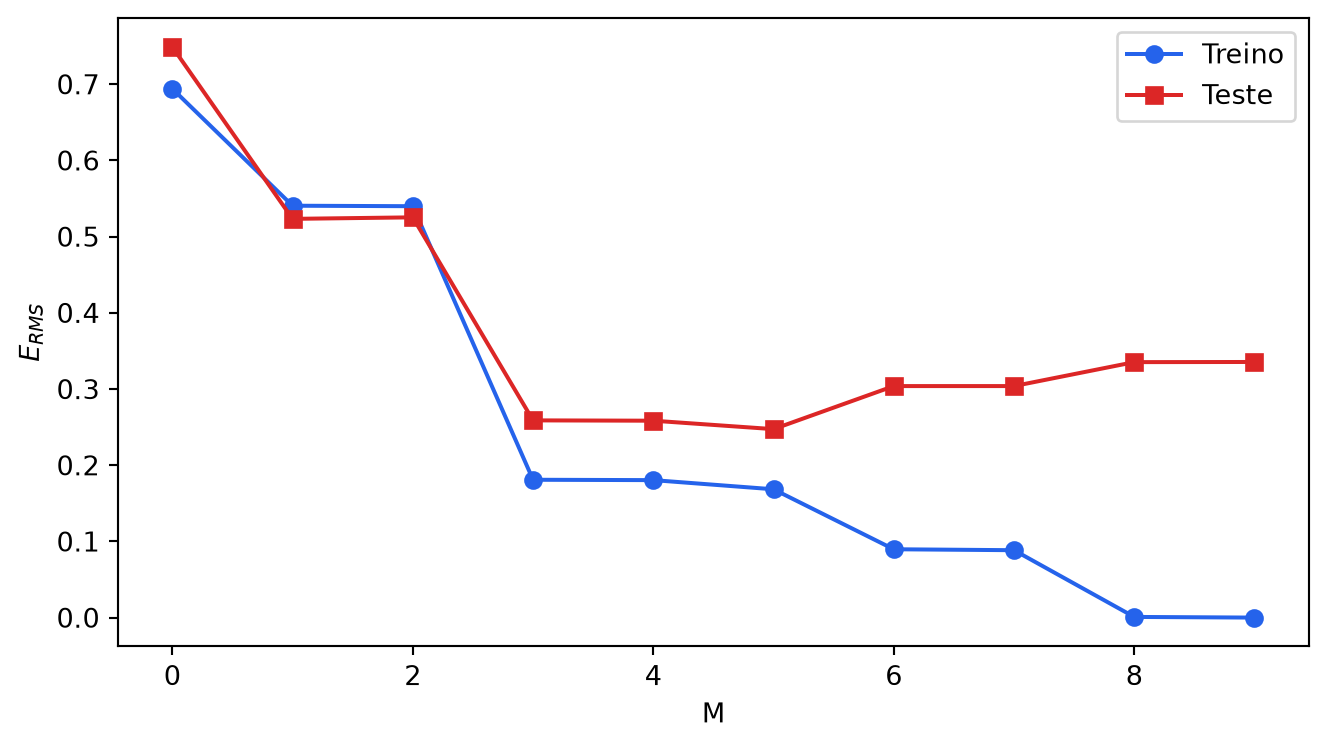
\(M = 0, 1\) : modelo rígido demais — não captura a oscilação (underfitting )\(M = 3\) : bom equilíbrio, próximo de \(\sin(2\pi x)\) \(M = 9\) : passa exatamente pelos pontos, \(E(\mathbf{w}^\star) = 0\) , mas oscila descontroladamente entre eles (overfitting )
Os coeficientes explodem
M=0
0.1
M=1
0.8
-1.4
M=3
0.0
10.9
-31.9
21.1
M=9
0.1
33.8
-652.5
5409.4
-21968.5
48012.7
-58323.4
37788.5
-10961.8
661.9
Quanto maior \(M\) , maiores em módulo ficam os coeficientes: o modelo se ajusta ao ruído , não ao sinal.
Regularização
Penaliza coeficientes grandes — adiciona um termo à função de erro:
\[\widetilde{E}(\mathbf{w}) = \frac{1}{2}\sum_{n=1}^N \{y(x_n,\mathbf{w}) - t_n\}^2 + \frac{\lambda}{2}\|\mathbf{w}\|^2\]
Em redes neurais, essa técnica é chamada de weight decay
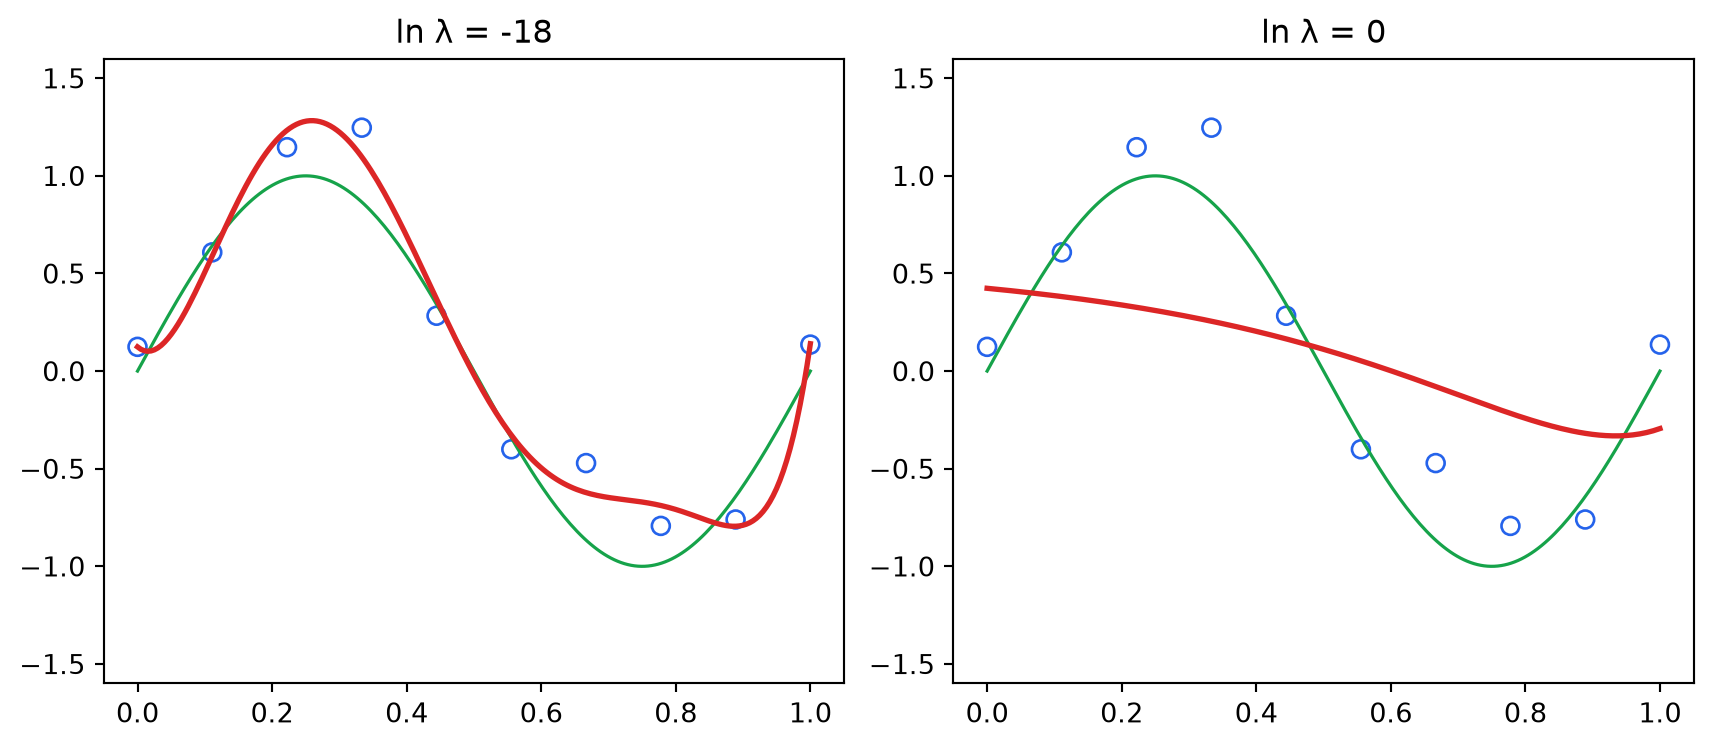
\(\lambda\) controla o trade-off entre ajuste aos dados e suavidade da curvaSolução ainda em forma fechada — só muda a matriz do sistema linear
Regularização — ajuste visual
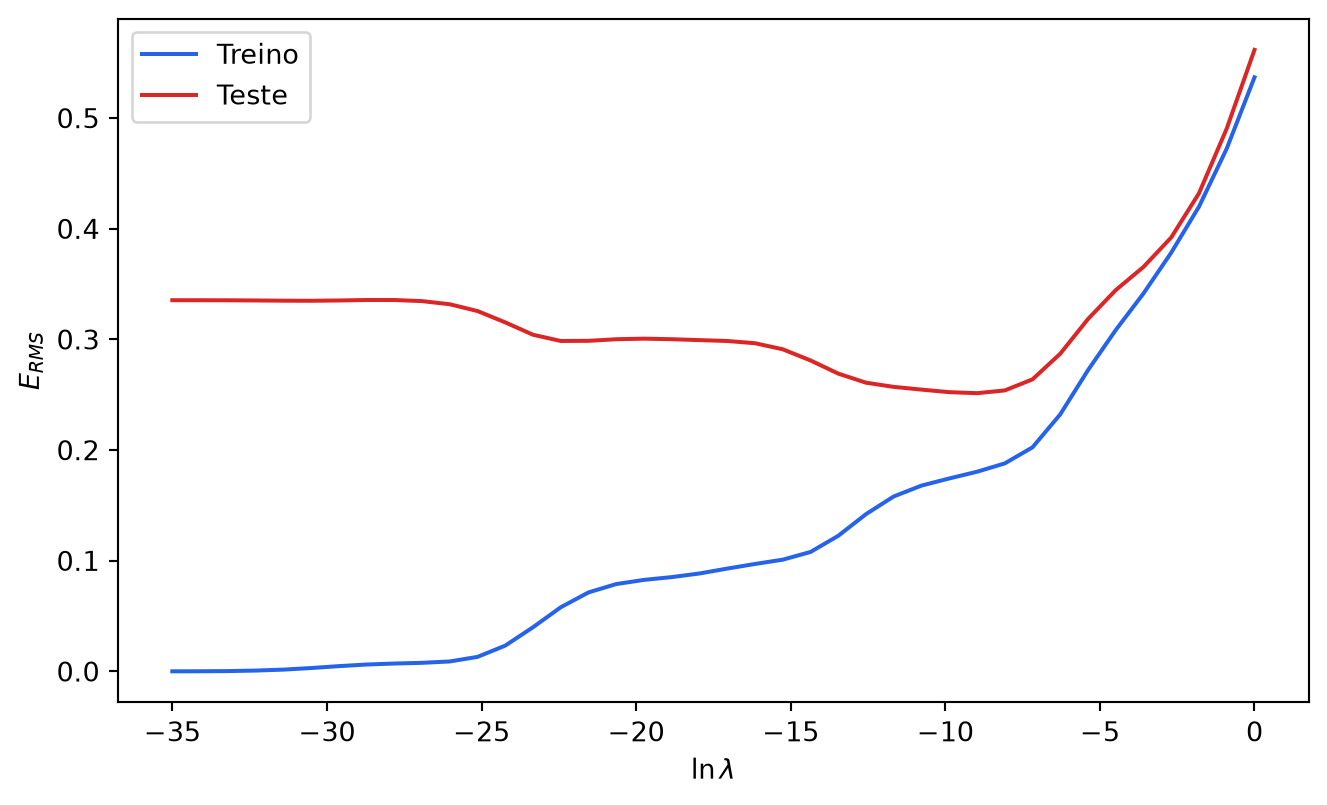
Efeito de \(\lambda\) na generalização
\(\lambda\) muito pequeno \(\to\) sobre-ajuste; \(\lambda\) muito grande \(\to\) sub-ajusteExiste um mínimo de erro de teste em algum \(\lambda\) intermediário
Seleção de modelo
\(M\) e \(\lambda\) são hiperparâmetros — não podem ser ajustados minimizando \(E(\mathbf{w})\) diretamente (levaria a \(\lambda \to 0\) e \(M\) grande)
Dividir os dados: treino / validação / teste
Escolher o modelo com menor erro na validação
Validação cruzada em S dobras (S-fold)
Dados divididos em \(S\) partes iguais
\(S{-}1\) partes treinam, 1 parte avalia — repete \(S\) vezes\(S = N\) \(\to\) leave-one-out Custo: \(S\times\) mais treinos
1.3 Breve história do aprendizado de máquina
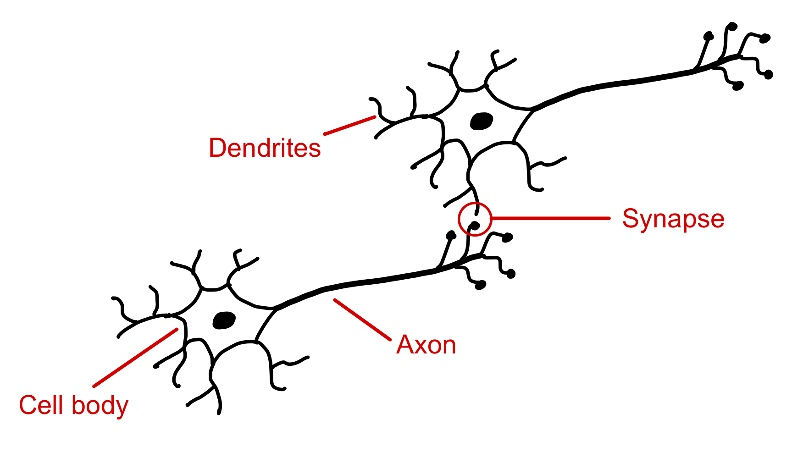
Redes neurais: inspiradas nos neurônios biológicos
Cérebro humano: ~90 bilhões de neurônios, ~100 trilhões de sinapses
Um neurônio “dispara” conforme a força (peso) das sinapses de entrada
A força das sinapses muda com a experiência \(\to\) é assim que o cérebro aprende
Três fases na história das redes neurais: camada única \(\to\) backpropagation \(\to\) redes profundas
Fase 1 — Redes de camada única
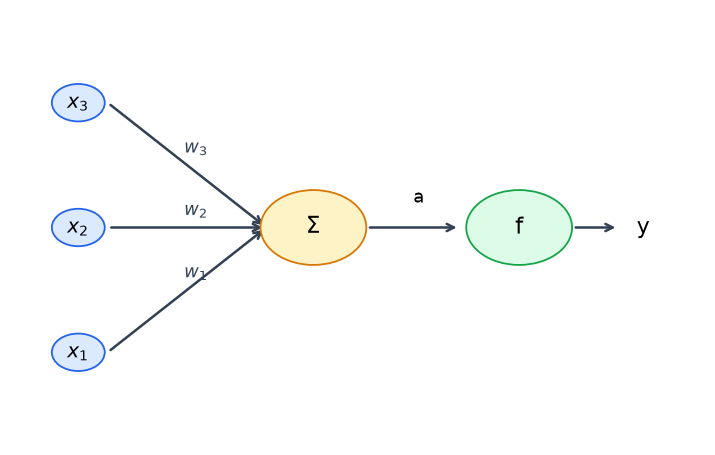
Um neurônio: entradas \(x_i\) , pesos \(w_i\) , soma \(a\) , ativação \(f(a) = y\)
Perceptron (Rosenblatt, 1962): \(f\) é uma função degrau
\[f(a) = \begin{cases} 0, & a \leqslant 0 \\ 1, & a > 0 \end{cases}\]
Algoritmo de treino converge em passos finitos, se existir solução
Minsky & Papert (1969): provaram limitações fortes de redes de camada única
Especularam (erroneamente) que multicamadas teriam a mesma limitação \(\to\) décadas de desinteresse
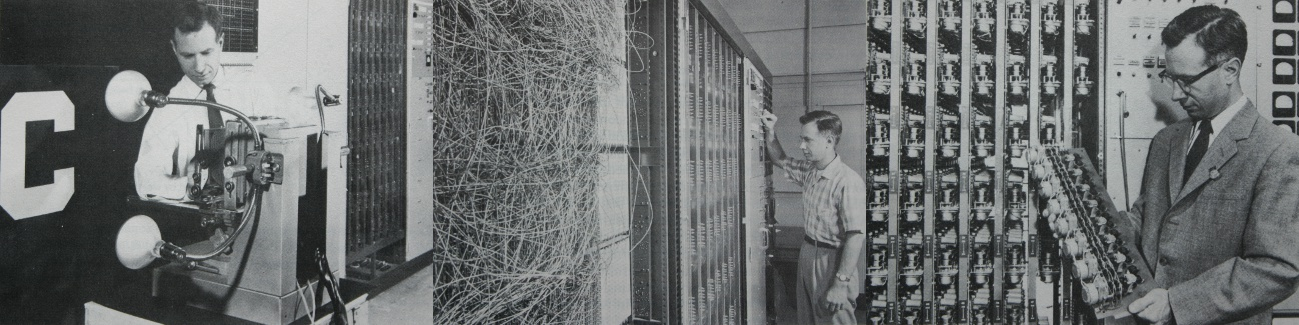
O hardware do Perceptron (1958)
Câmera rudimentar (400 pixels) \(\cdot\) patch board para religar conexões \(\cdot\) pesos ajustados por motores elétricos girando potenciômetros
Fase 2 — Backpropagation
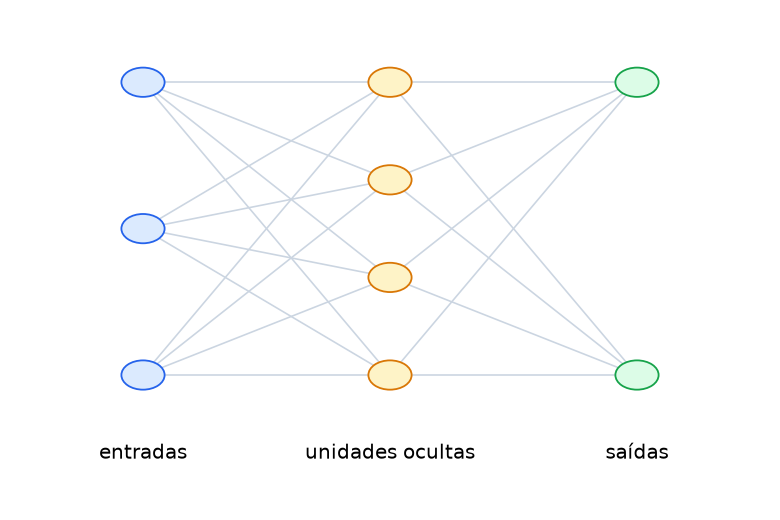
Rede com uma camada oculta — informação flui para frente
Ativações diferenciáveis substituem a função degrau
Gradiente do erro calculado eficientemente por retropropagação (Rumelhart, Hinton & Williams, 1986)
Otimização por gradiente descendente estocástico
Na prática, só as últimas camadas aprendiam bem \(\to\) redes ficavam rasas
Fase 3 — Redes profundas
Escala (dados + modelo + cômputo) supera melhorias arquiteturais isoladas (Sutton, 2019)
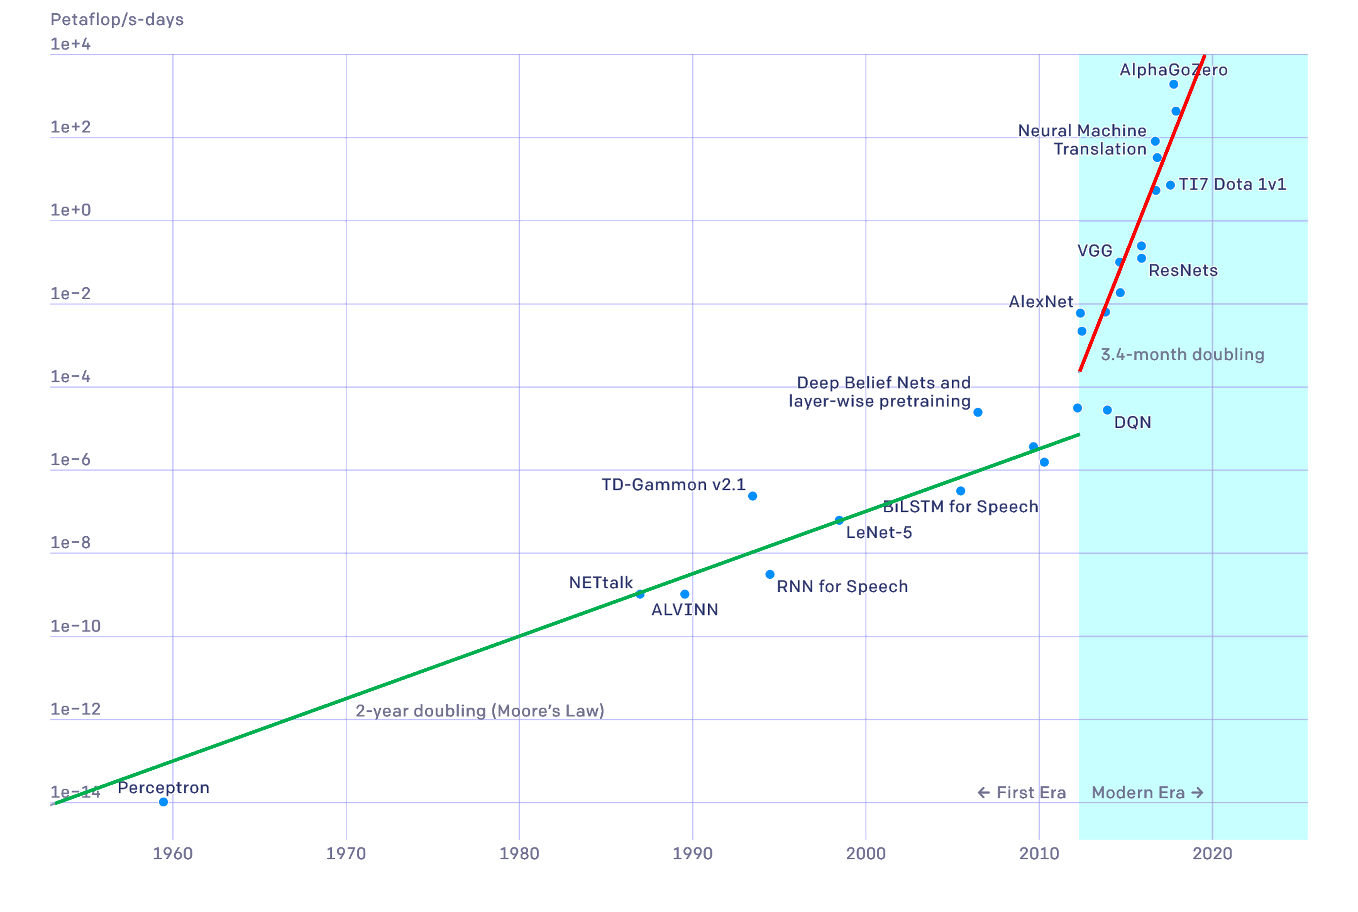
Desde 2012: cômputo cresce dobrando a cada 3,4 meses
Antes (era do perceptron): dobrava a cada ~2 anos (Lei de Moore)
GPUs : paralelismo massivo casa com o cálculo por camadasRedes com até ~\(10^{12}\) parâmetros, treináveis graças a conexões residuais e diferenciação automática
Ideias-chave do capítulo
Mesmo framework de deep learning resolve problemas supervisionados, não supervisionados e auto-supervisionados
Generalização — não decorar o treino — é o objetivo real do aprendizadoComplexidade do modelo (\(M\) , \(\lambda\) …) precisa ser controlada: sub-ajuste \(\leftrightarrow\) sobre-ajusteRegularização troca viés por variância para melhorar a generalizaçãoHiperparâmetros exigem validação separada do treino e do teste
Redes profundas = escala (dados + parâmetros + cômputo) + avanços como backprop, GPUs, conexões residuais
\[\text{dados} + \text{modelo} + \text{erro} + \text{otimização} \;\longrightarrow\; \text{aprendizado}\]