Probabilidades
Parte 1: Regras da Probabilidade, Densidades e Distribuição Gaussiana
Prof. Dr. Raphael Teixeira
Probabilidades
Baseado no Capítulo 2 — Probabilities — de:
C. M. Bishop & H. Bishop, Deep Learning: Foundations and Concepts , Springer, 2024.
Capítulo grande — dividido em duas partes. Parte 1:
Regras da probabilidade — soma, produto, BayesDensidades de probabilidade Distribuição Gaussiana
Incerteza em aprendizado de máquina
Toda aplicação de ML lida com incerteza. Dois tipos:
Incerteza epistêmica (sistemática) — vem de termos apenas um conjunto finito de dados; diminui com mais dadosIncerteza aleatória (irredutível) — ruído intrínseco, informação parcial sobre o mundo; não desaparece só com mais dados do mesmo tipo
Exemplo: uma biópsia é mais informativa que a imagem da lesão sozinha — reduz a incerteza aleatória ao acrescentar uma nova fonte de informação.
Ambas são tratadas com o mesmo formalismo: teoria da probabilidade .
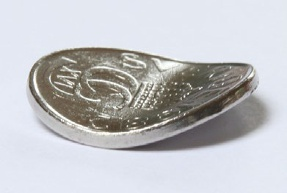
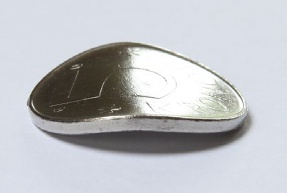
A moeda tortuosa
Lado côncavo: 60% das vezes. Lado convexo: 40%
Frequentista : probabilidade = frequência em repetições infinitasBayesiana : probabilidade = grau de crença/incerteza, mesmo em eventos não repetíveis (qual lado é “cara”?)A visão bayesiana generaliza a frequentista
2.1 Rastreio de câncer: o problema
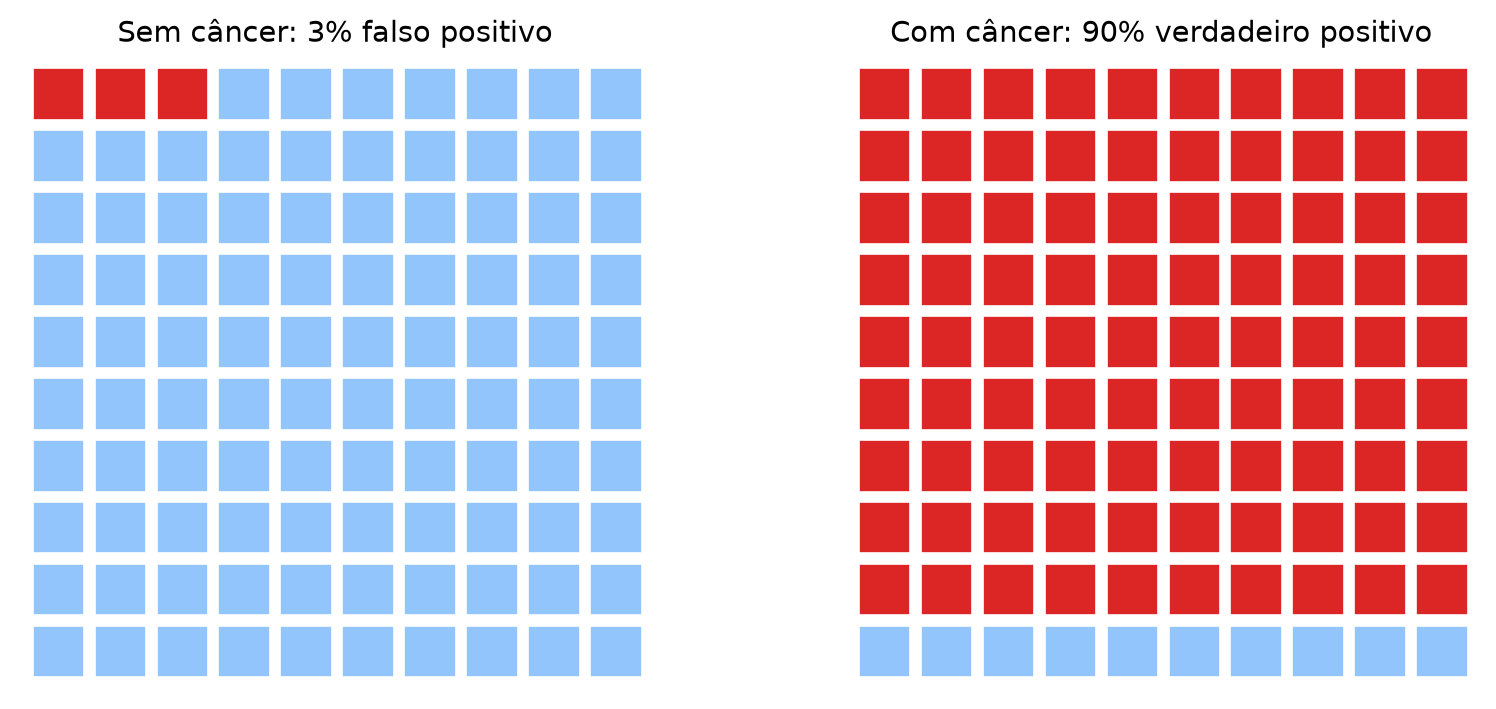
Rastrear uma população para detecção precoce de câncer:
1% da população tem câncer (prevalência )
Falso positivo : 3% dos saudáveis testam positivoFalso negativo : 10% dos doentes testam negativo
Quem testa positivo tem câncer? Vamos calcular adiante.
Regra da soma e regra do produto
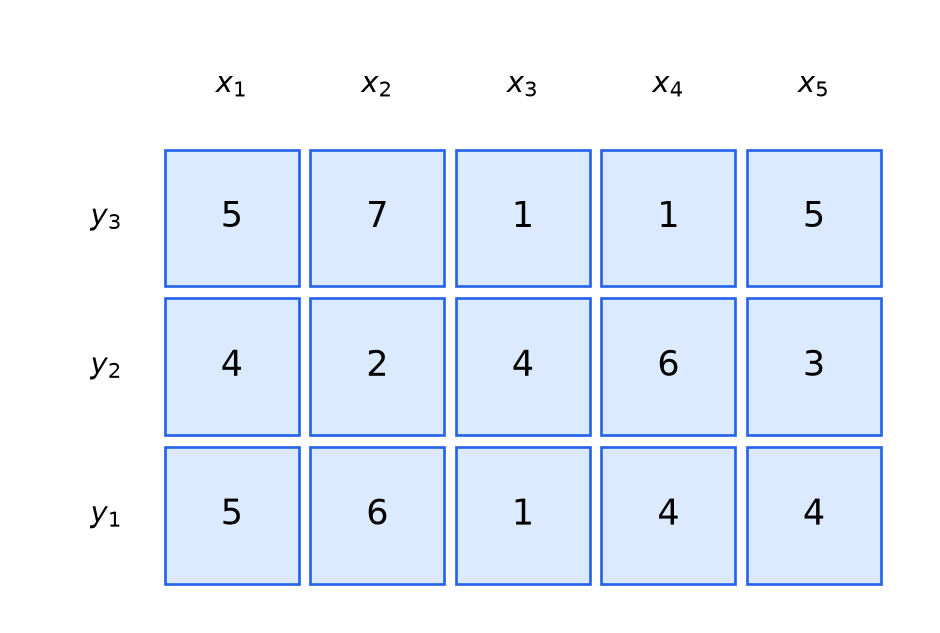
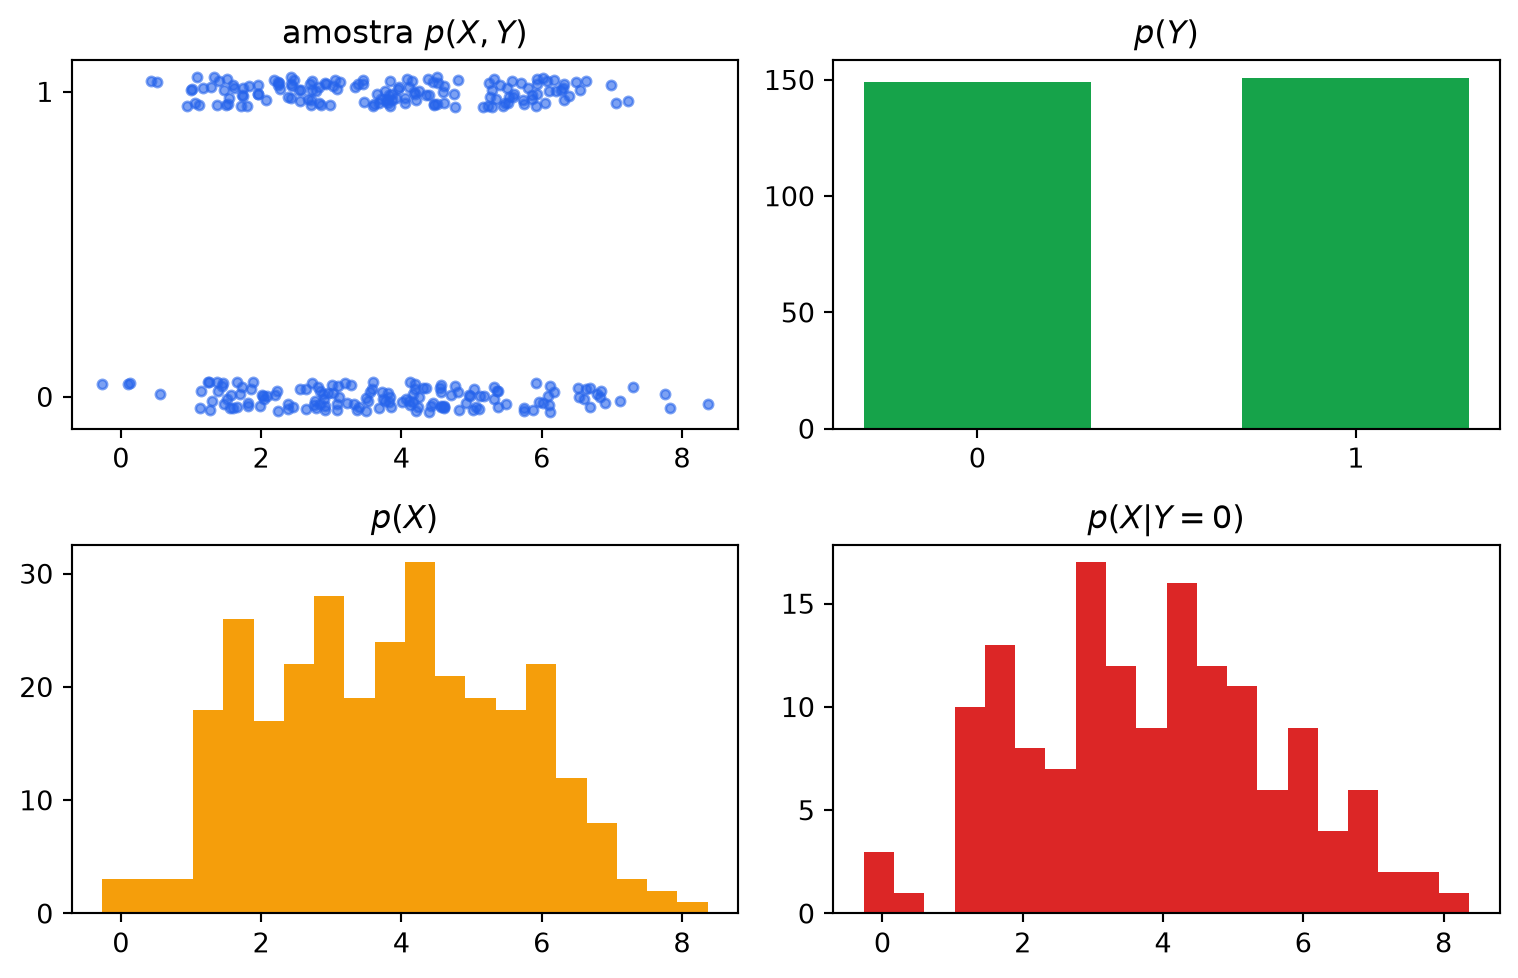
Cada célula: \(n_{ij}\) ocorrências de \(X{=}x_i, Y{=}y_j\)
\[\text{soma:}\quad p(X) = \sum_Y p(X,Y)\]
\[\text{produto:}\quad p(X,Y) = p(Y|X)\,p(X)\]
\(p(X,Y)\) : probabilidade conjunta \(p(X)\) : probabilidade marginal (soma sobre \(Y\) )\(p(Y|X)\) : probabilidade condicional
Marginais e condicionais na prática
Teorema de Bayes
Da regra do produto e da simetria \(p(X,Y)=p(Y,X)\) :
\[p(Y|X) = \frac{p(X|Y)\,p(Y)}{p(X)} \qquad\text{com}\qquad p(X) = \sum_Y p(X|Y)\,p(Y)\]
Relaciona \(p(Y|X)\) com a condicional invertida \(p(X|Y)\)
O denominador é só uma normalização — garante que a soma sobre \(Y\) dê 1
Uma das ferramentas mais importantes do aprendizado de máquina
Rastreio de câncer: a resposta
= 0.01 , 0.99 # prevalência = 0.90 , 0.03 # p(T=1|C=1), p(T=1|C=0) = pT1_C1 * pC1 + pT1_C0 * pC0 # regra da soma = (pT1_C1 * pC1) / pT1 # teorema de Bayes print (f"p(T=1) = { pT1:.4f} " )print (f"p(C=1|T=1) = { pC1_T1:.4f} " )
p(T=1)     = 0.0387
p(C=1|T=1) = 0.2326
Um teste “de 90%/97%” deixa só 23% de chance real — a prevalência baixa domina.
Prior, posterior e independência
\(p(C)\) antes do teste: probabilidade a priori \(p(C|T)\) depois do teste: probabilidade a posteriori Prior 1% \(\to\) posterior 23%: o teste positivo é evidência forte, mas parte de uma base rara
\(X\) e \(Y\) são independentes se \(p(X,Y) = p(X)p(Y)\) , ou equivalentemente \(p(Y|X) = p(Y)\) Um teste independente do diagnóstico (\(p(T|C){=}p(T)\) ) não mudaria a probabilidade de câncer — seria inútil
2.2 Densidades de probabilidade
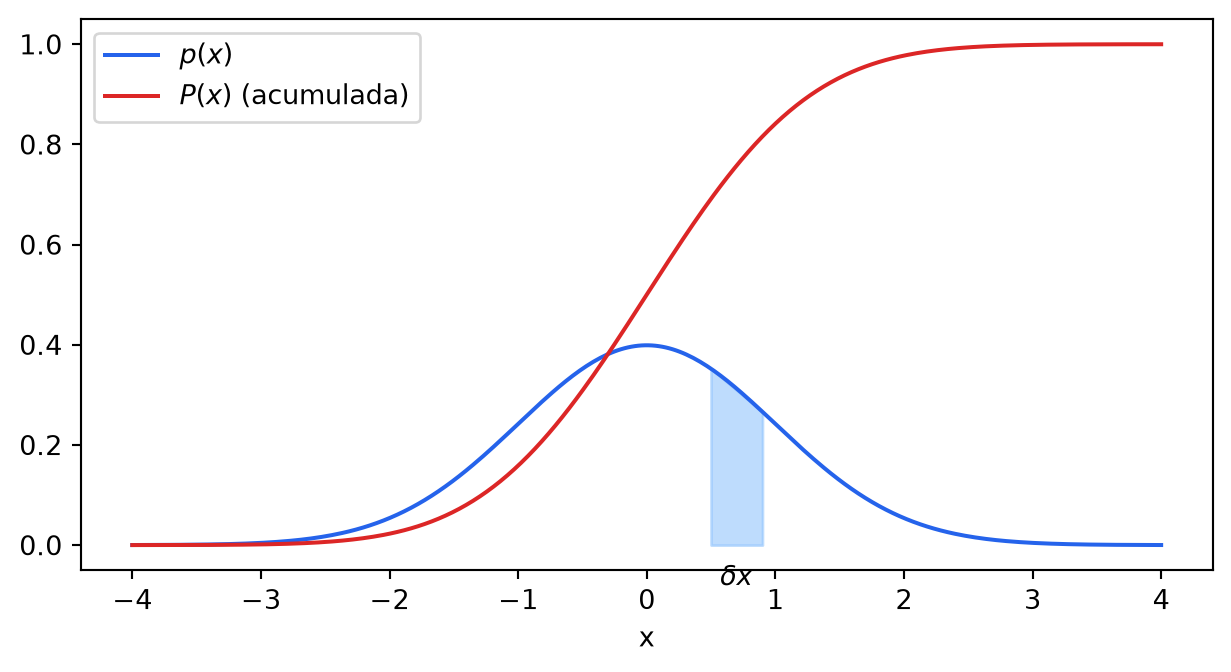
Para variáveis contínuas , \(p(x=\text{valor exato})=0\) . Definimos a densidade \(p(x)\) :
\[p(x \in (a,b)) = \int_a^b p(x)\,dx \qquad p(x) \geqslant 0 \qquad \int_{-\infty}^{\infty} p(x)\,dx = 1\]
\(P(z) = \int_{-\infty}^z p(x)\,dx\) é a função de distribuição acumulada , com \(P'(x) = p(x)\) .
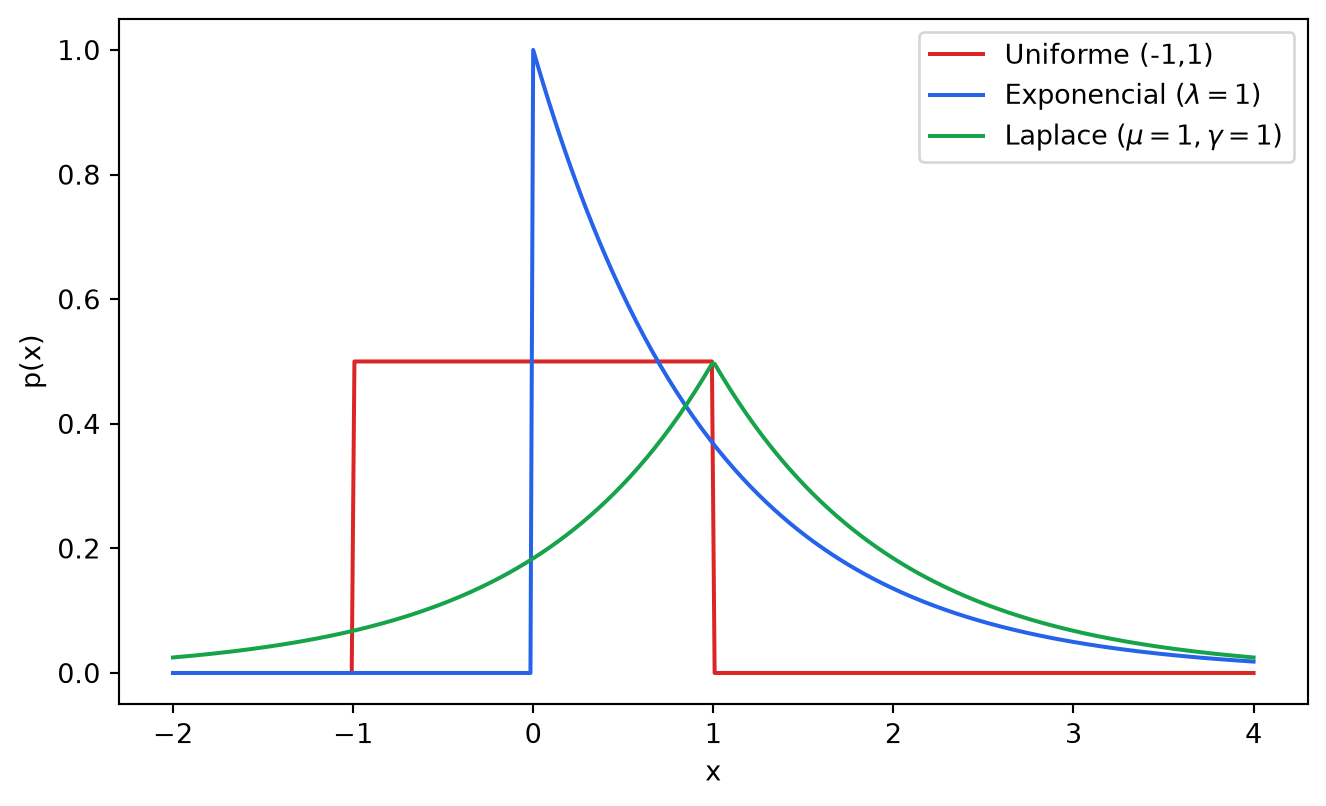
Distribuições exemplo
Delta de Dirac \(\delta(x-\mu)\) : pico infinito em \(\mu\) , área unitária — útil para representar dados observados como distribuição empírica \(p(x|D) = \tfrac{1}{N}\sum_n \delta(x-x_n)\)
Esperança, variância e covariância
Esperança (média ponderada de \(f(x)\) sob \(p(x)\) ):
\[\mathbb{E}[f] = \sum_x p(x)f(x) \qquad\text{ou}\qquad \mathbb{E}[f] = \int p(x)f(x)\,dx\]
Com \(N\) amostras: \(\;\mathbb{E}[f] \approx \frac{1}{N}\sum_{n=1}^N f(x_n)\)
Variância e covariância :
\[\text{var}[f] = \mathbb{E}[(f(x)-\mathbb{E}[f(x)])^2] = \mathbb{E}[f(x)^2] - \mathbb{E}[f(x)]^2\]
\[\text{cov}[x,y] = \mathbb{E}_{x,y}[xy] - \mathbb{E}[x]\mathbb{E}[y]\]
2.3 A distribuição Gaussiana
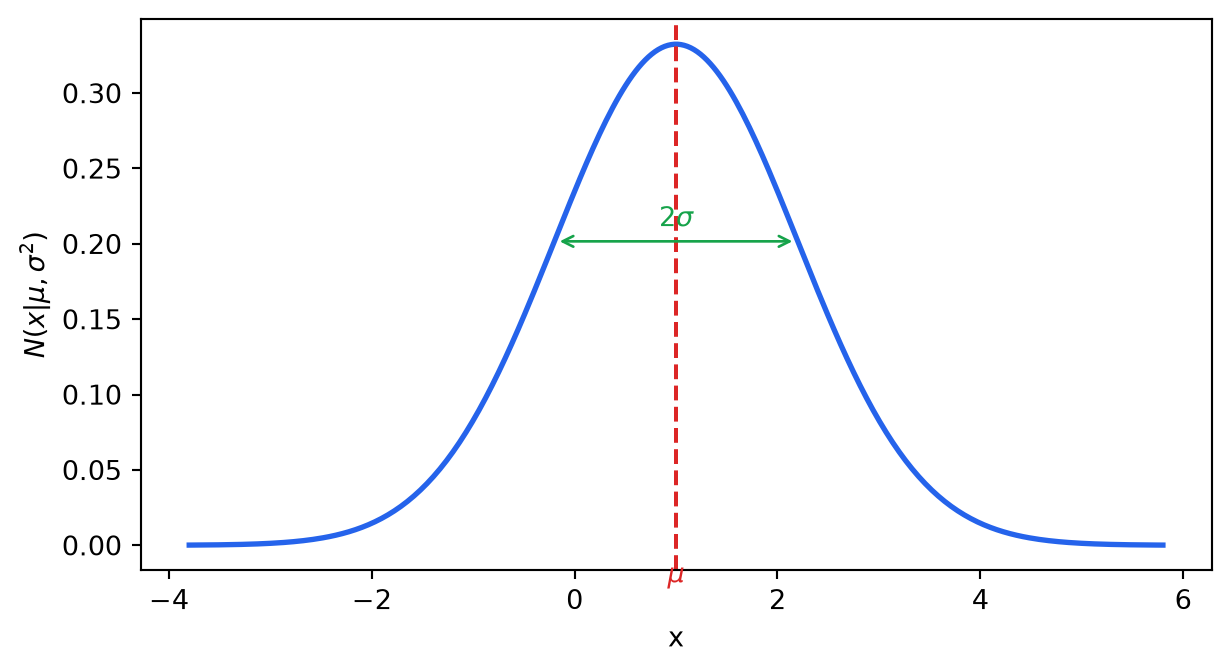
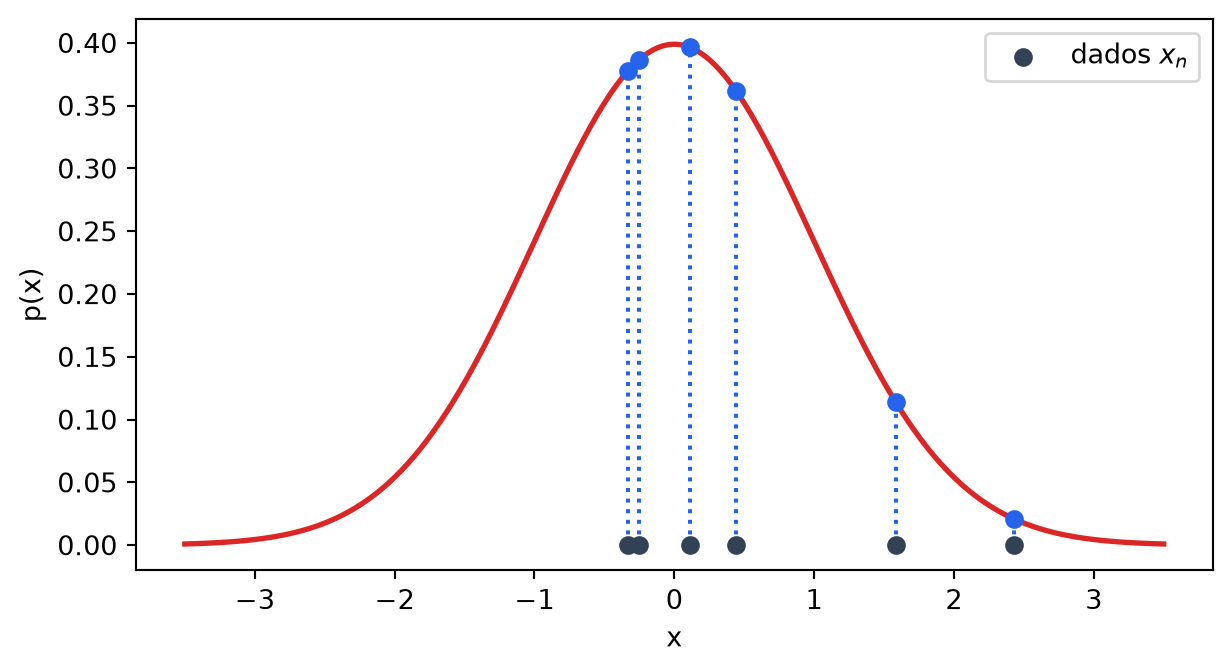
\[N(x|\mu,\sigma^2) = \frac{1}{(2\pi\sigma^2)^{1/2}}\exp\left(-\frac{1}{2\sigma^2}(x-\mu)^2\right)\]
\(\mu\) : média \(\quad\) \(\sigma^2\) : variância \(\quad\) \(\sigma\) : desvio padrão \(\quad\) \(\beta{=}1/\sigma^2\) : precisão
Verossimilhança (likelihood)
Dado \(\mathbf{x}=(x_1,\ldots,x_N)\) i.i.d. de uma Gaussiana, a verossimilhança é o produto:
\[p(\mathbf{x}|\mu,\sigma^2) = \prod_{n=1}^N N(x_n|\mu,\sigma^2)\]
Maximizar a verossimilhança = escolher \(\mu,\sigma^2\) que melhor explicam os dados.
Máxima verossimilhança: solução
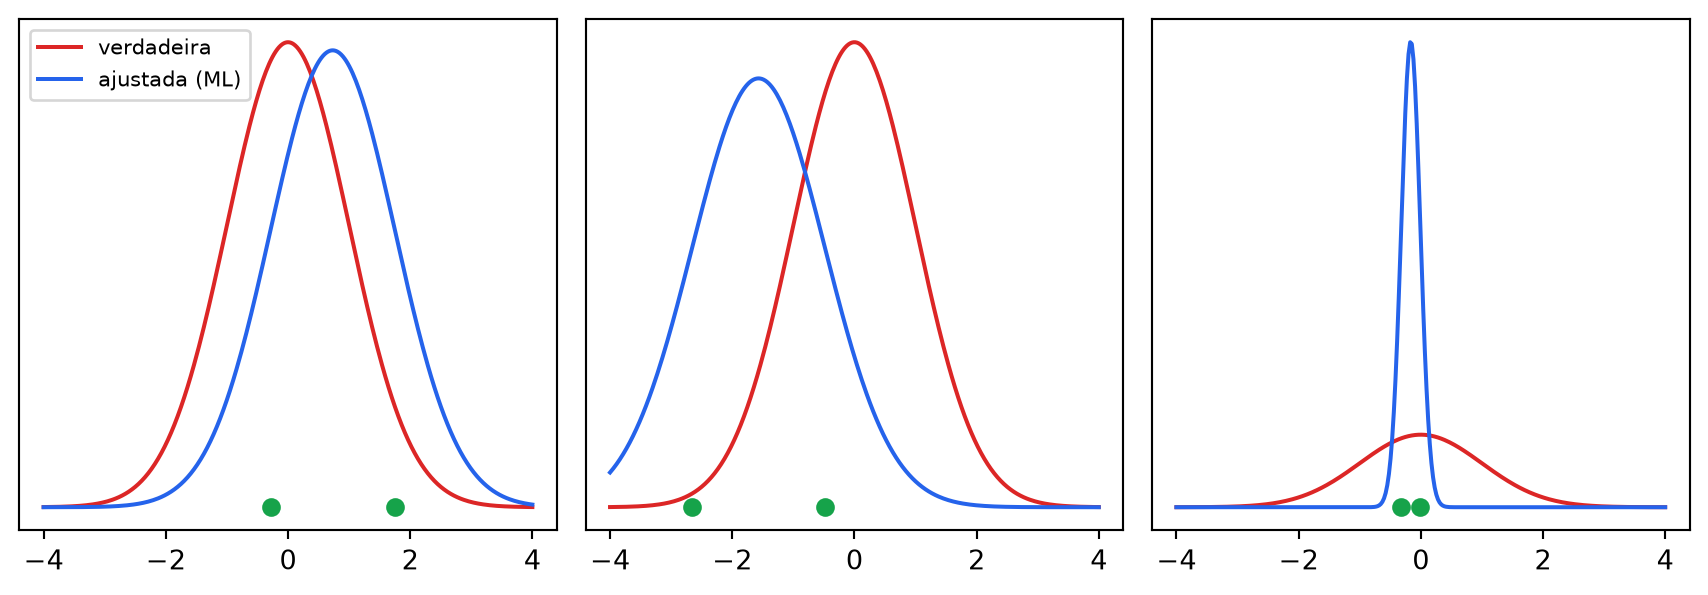
Maximizando o log da verossimilhança (mais conveniente numericamente):
\[\mu_{ML} = \frac{1}{N}\sum_{n=1}^N x_n \qquad\qquad \sigma^2_{ML} = \frac{1}{N}\sum_{n=1}^N (x_n - \mu_{ML})^2\]
\(\mu_{ML}\) : a média amostral \(\quad\) \(\sigma^2_{ML}\) : a variância amostral Otimização conjunta, mas \(\mu_{ML}\) pode ser calculada primeiro e reaproveitada em \(\sigma^2_{ML}\)
Máxima verossimilhança: em código
0 )= 2.0 , 1.5 = np.random.normal(mu_true, sigma_true, 20 )= data.mean()= np.mean((data - mu_ml)** 2 )print (f"mu_ML = { mu_ml:.3f} (verdadeiro: { mu_true} )" )print (f"sigma2_ML = { var_ml:.3f} (verdadeiro: { sigma_true** 2 } )" )
mu_ML     = 2.854  (verdadeiro: 2.0)
sigma2_ML = 1.626  (verdadeiro: 2.25)
Viés da máxima verossimilhança
\[\mathbb{E}[\mu_{ML}] = \mu \qquad\qquad \mathbb{E}[\sigma^2_{ML}] = \frac{N-1}{N}\sigma^2\]
A variância estimada é sistematicamente subestimada — a versão corrigida usa \(\tfrac{1}{N-1}\) no lugar de \(\tfrac{1}{N}\) .
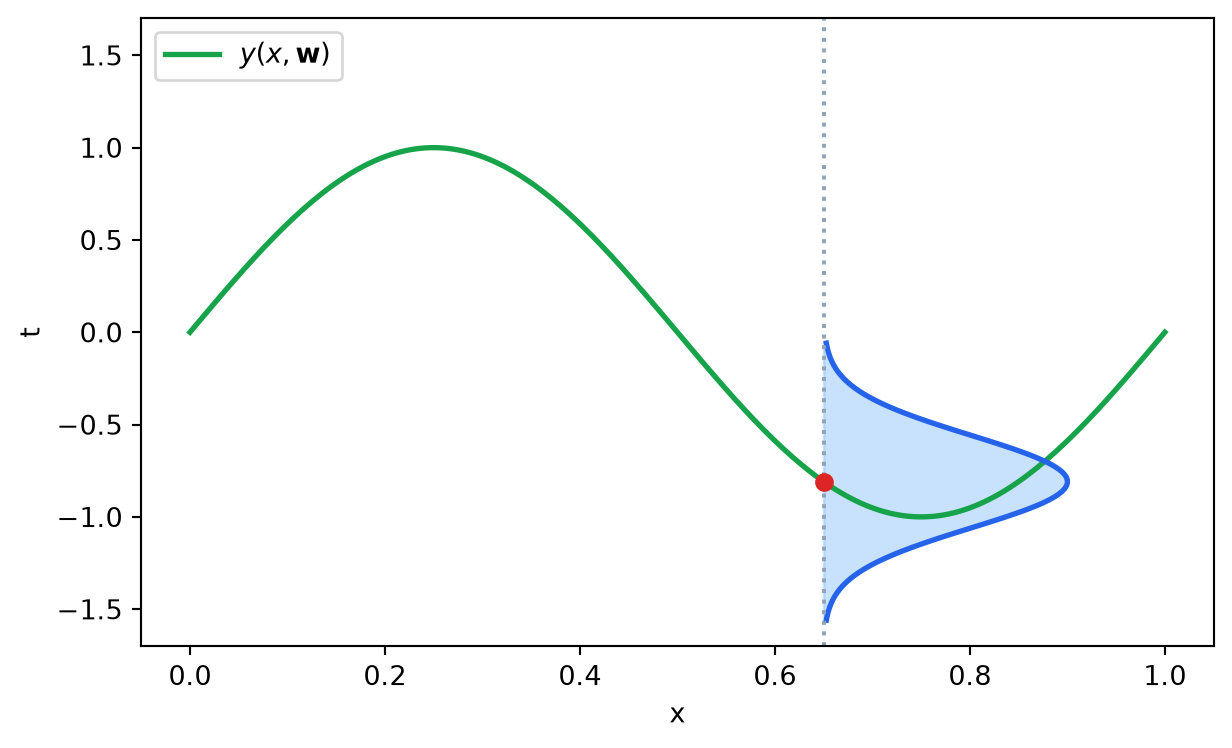
Regressão linear: visão probabilística
\[p(t|x,\mathbf{w},\sigma^2) = N(t\,|\,y(x,\mathbf{w}),\,\sigma^2)\]
Maximizar essa verossimilhança \(\equiv\) minimizar o erro quadrático do Capítulo 1!
Ideias-chave da Parte 1
Incerteza epistêmica (dados finitos) \(\times\) aleatória (ruído intrínseco) — a probabilidade modela ambas
Regra da soma (\(p(X)=\sum_Y p(X,Y)\) ) e regra do produto (\(p(X,Y){=}p(Y|X)p(X)\) ) são a base de tudoTeorema de Bayes inverte condicionais: posterior \(\propto\) verossimilhança \(\times\) priorDensidades contínuas generalizam probabilidades discretas via integrais
A Gaussiana é a distribuição contínua mais usada em ML — média e variância bastam para descrevê-la
Máxima verossimilhança é enviesada, mas o viés desaparece quando \(N\to\infty\) O erro quadrático do Capítulo 1 é a verossimilhança de um ruído gaussiano
Próxima parte: transformação de densidades, teoria da informação e probabilidade bayesiana.