flowchart LR
  X["Sistema não linear<br/>x⁺ = f(x,u)"] -->|"ψ(x) (não linear)"| Z["Preditor linear<br/>z⁺ = Az + Bu<br/>x̂ = Cz"]
  Z -->|"QP convexo"| M["MPC linear<br/>(ou LQR)"]
  M -->|"u_k"| X
Koopman-MPC
Preditores Lineares para Sistemas Não Lineares — Korda & Mezić (2018)
Prof. Dr. Raphael Teixeira
Universidade Federal do Pará
Motivação: MPC Não Linear é Caro
Um conversor de potência (ou um motor) é não linear — produtos estado×comando como \(i_L\,d\) ou \(\omega\,u\) aparecem no modelo médio. O MPC não linear (NMPC) resolve, a cada período de amostragem,
\[ \min_{u_0,\dots,u_{N_p-1}} \sum_{i=0}^{N_p-1} \ell(\bar x_i,u_i) \quad\text{s.a.}\quad \bar x_{i+1}=f(\bar x_i,u_i),\;\; \bar x_0=x_k \]
- A restrição de igualdade \(\bar x_{i+1}=f(\bar x_i,u_i)\) torna o problema não convexo: mínimos locais, tempo de solução imprevisível;
- Em eletrônica de potência o orçamento é de dezenas de µs a poucos ms;
- Linearizar em torno de um ponto de operação dá um QP rápido, mas o modelo só vale perto daquele ponto.
Existe um modelo linear que prevê bem o sistema não linear em toda a região de operação, e que se obtém só a partir de dados?
A Ideia de Korda & Mezić
Levantar (lift) o estado para um espaço de dimensão maior onde a evolução é (aproximadamente) linear, mantendo \(u\) sem levantar (Korda; Mezić, 2018a):
\[ z_{k+1} = A z_k + B u_k,\qquad \hat x_k = C z_k,\qquad z_0=\psi(x_0)=\begin{bmatrix}\psi_1(x_0)\\ \vdots\\ \psi_N(x_0)\end{bmatrix},\quad N\gg n \]
Como \(u\) entra linearmente e \(\hat x\) é linear em \(z\), restrições lineares em \(u\) e \(x\) continuam lineares — o MPC vira um QP. Ainda assim, a lei resultante \(\kappa(x)=\kappa_{\text{lift}}(\psi(x))\) é não linear no estado original.
Formalismo (1): Koopman com Entrada
Recordando o caso autônomo \(x^+=f(x)\): o operador de Koopman age sobre observáveis, \((\mathcal K\psi)(x)=\psi(f(x))\) — linear, de dimensão infinita.
Com entrada, a dinâmica \(x^+=f(x,u)\) não é autônoma. Truque: incluir a sequência inteira de entradas no estado. Seja \(\mathbf u=(u_0,u_1,\dots)\in\ell(\mathcal U)\) e o estado estendido \(\chi=(x,\mathbf u)\):
\[ \chi^+ = F(\chi) := \begin{bmatrix} f(x,\mathbf u(0)) \\ \mathcal S\mathbf u \end{bmatrix}, \qquad (\mathcal S\mathbf u)(i)=\mathbf u(i+1)\quad\text{(deslocamento à esquerda)} \]
Agora o sistema é autônomo em \(\mathbb R^n\times\ell(\mathcal U)\), e o operador de Koopman é o usual:
\[ (\mathcal K\varphi)(\chi) = \varphi(F(\chi)),\qquad \varphi:\mathbb R^n\times\ell(\mathcal U)\to\mathbb R \]
Nota
\(\chi\) é um objeto de dimensão infinita — o EDMD direto sobre \(\chi\) não é computável. A estrutura do dicionário, no próximo slide, resolve isso.
Formalismo (2): Dicionário que Gera um Sistema Linear
O EDMD procura \(\mathcal A\) que minimiza \(\sum_j \|\varphi(\chi_j^+)-\mathcal A\varphi(\chi_j)\|_2^2\). Impondo observáveis não lineares em \(x\) e lineares em \(\mathbf u\), e por causalidade só \(\mathbf u(0)\):
\[ \varphi(x,\mathbf u) = \begin{bmatrix}\psi(x)\\ \mathbf u(0)\end{bmatrix} \;\;\Rightarrow\;\; \varphi(\chi^+) - \mathcal A\varphi(\chi) = \begin{bmatrix}\psi(x^+)\\ \mathbf u(1)\end{bmatrix} - \begin{bmatrix}A & B\\ \star & \star\end{bmatrix}\begin{bmatrix}\psi(x)\\ \mathbf u(0)\end{bmatrix} \]
Não queremos prever a própria entrada: descartamos as últimas \(m\) linhas. Sobram as \(N\) primeiras, com \(\bar{\mathcal A}=[A\;\;B]\):
\[ \boxed{\;\min_{A,B}\;\sum_{j=1}^{K}\big\|\psi(x_j^+) - A\psi(x_j) - Bu_j\big\|_2^2\;} \qquad \min_{C}\;\sum_{j=1}^{K}\big\|x_j - C\psi(x_j)\big\|_2^2 \]
É o DMDc (Proctor; Brunton; Kutz, 2016) aplicado aos dados levantados. Se \(\psi\) contém o próprio estado, \(\psi_{1:n}(x)=x\), então \(C=[I\;\;0]\).
Formalismo (3): Solução por Mínimos Quadrados
Com os dados \((x_j,u_j,x_j^+)\) — sem exigir ordem temporal —, \(X_{\text{lift}}=[\psi(x_1)\cdots\psi(x_K)]\), \(Y_{\text{lift}}=[\psi(x_1^+)\cdots\psi(x_K^+)]\) e \(U=[u_1\cdots u_K]\), o problema \(\min_{A,B}\|Y_{\text{lift}}-AX_{\text{lift}}-BU\|_F\) tem solução
\[ [A\;\;B] = Y_{\text{lift}}\begin{bmatrix}X_{\text{lift}}\\ U\end{bmatrix}^{\dagger} \]
Na prática, com \(K\gg N\), resolvem-se as equações normais (tamanho independente de \(K\)):
\[ [A\;\;B]\,\underbrace{\begin{bmatrix}X_{\text{lift}}\\ U\end{bmatrix}\begin{bmatrix}X_{\text{lift}}\\ U\end{bmatrix}^{\!\top}}_{G\;\in\;\mathbb R^{(N+m)\times(N+m)}} = \underbrace{Y_{\text{lift}}\begin{bmatrix}X_{\text{lift}}\\ U\end{bmatrix}^{\!\top}}_{V\;\in\;\mathbb R^{N\times(N+m)}} \]
\(G\) e \(V\) podem ser acumulados amostra a amostra (\(G \leftarrow G + w_jw_j^\top\)): milhões de amostras cabem em memória \(O((N+m)^2)\).
Formalismo (4): O Que o EDMD Estima de Fato
Projeção \(L^2\) (Korda; Mezić, 2018b). Seja \(\hat\mu_K=\frac1K\sum_i\delta_{\chi_i}\) a medida empírica dos dados e \(\mathcal H_N=\operatorname{span}\{\varphi_1,\dots,\varphi_N\}\). A matriz do EDMD define \(\mathcal K_{N,K}=P_N^{\hat\mu_K}\,\mathcal K|_{\mathcal H_N}\): a projeção ortogonal (em \(L^2(\hat\mu_K)\)) do operador de Koopman sobre o subespaço do dicionário.
- \(K\to\infty\) (amostras i.i.d. de \(\mu\)): \(\mathcal K_{N,K}\to P_N^{\mu}\mathcal K|_{\mathcal H_N}\) com probabilidade 1 — convergência em norma de operador e do espectro;
- \(N\to\infty\) (base ortonormal de \(L^2(\mu)\)): convergência forte a \(\mathcal K\) e, para o estado, predições de horizonte finito convergem;
- Porém: o dicionário \([\psi(x);\,u(0)]\) não é uma base completa — para o preditor linear só se garante convergência à projeção sobre \(\mathcal H_\infty\), não ao sistema verdadeiro.
Importante
Consequência prática: o preditor linear é bom em horizonte finito, não exato. Isso casa perfeitamente com o MPC, que só usa \(N_p\) passos.
Algoritmo (1): Identificação do Preditor
# Entrada: (x_j, u_j, x_j^+), j = 1..K (qualquer ordem); dicionário ψ: R^n → R^N
1: X_lift ← [ψ(x_1) … ψ(x_K)]           # N × K
2: Y_lift ← [ψ(x_1^+) … ψ(x_K^+)]       # N × K
3: W      ← [X_lift ; U]                 # (N+m) × K
4: G ← W Wᵀ ;  V ← Y_lift Wᵀ             # equações normais
5: [A  B] ← V G⁺                         # N × (N+m)
6: C ← X X_lift⁺                         # = [I 0] se ψ contém x
# Saída: z⁺ = A z + B u,  x̂ = C z,  z_0 = ψ(x_0)
Escolhas do projetista: dicionário \(\psi\) e \(N\); excitação que cubra a região de operação; \(T_s\) e nº de trajetórias.
Custo: \(O(KN)\) avaliações de \(\psi\), \(O(KN^2)\) para montar \(G\), \(O(N^3)\) para resolver — nenhuma otimização não convexa.
Algoritmo (2): O Problema de MPC Levantado
A cada instante \(k\), com \(z_0=\psi(x_k)\) como parâmetro:
\[ \begin{aligned} \min_{u_i,\,z_i}\;\; & z_{N_p}^\top Q_{N_p} z_{N_p} + \sum_{i=0}^{N_p-1}\big(z_i^\top Q_i z_i + u_i^\top R_i u_i + q_i^\top z_i + r_i^\top u_i\big)\\ \text{s.a.}\;\; & z_{i+1} = A z_i + B u_i, \qquad E_i z_i + F_i u_i \le b_i,\qquad z_0=\psi(x_k) \end{aligned} \]
- QP convexo — solvers maduros (qpOASES, OSQP), solução global e tempo previsível;
- Custo ou restrição não linear em \(x\)? Coloque a função no dicionário: ex. restringir \(g(x)\le 0\) \(\Rightarrow\) \(\psi_j = g\) e \(E_i = e_j^\top\);
- Rastreamento de saída \(y=Cz\): expandir \((Cz_i-y_r)^\top Q(Cz_i-y_r)\) dá termos \(Q_i=C^\top QC\) e \(q_i=-2C^\top Q y_r\) (constantes descartadas).
Nota
Comparado ao NMPC: a dinâmica \(f\) sai da otimização e vai para o lifting \(\psi(x_k)\), avaliado uma vez por passo.
Algoritmo (3): Forma Densa
Eliminando \(z_i\) por recursão, \(z_i = A^i z_0 + \sum_{j=0}^{i-1}A^{i-1-j}Bu_j\). Empilhando \(\mathbf y=[y_1;\dots;y_{N_p}]\) e \(\mathbf U=[u_0;\dots;u_{N_p-1}]\):
\[ \mathbf y = \underbrace{\begin{bmatrix} CA\\ CA^2\\ \vdots\\ CA^{N_p}\end{bmatrix}}_{\Phi\;\in\;\mathbb R^{pN_p\times N}} z_0 + \underbrace{\begin{bmatrix} CB & 0 & \cdots & 0\\ CAB & CB & \cdots & 0\\ \vdots & & \ddots & \\ CA^{N_p-1}B & \cdots & CAB & CB\end{bmatrix}}_{\Gamma\;\in\;\mathbb R^{pN_p\times mN_p}}\mathbf U \]
\[ J=\|\mathbf y-\mathbf r\|_{\bar Q}^2+\|\mathbf U\|_{\bar R}^2 = \mathbf U^\top\underbrace{(\Gamma^\top\bar Q\Gamma+\bar R)}_{H\;\in\;\mathbb R^{mN_p\times mN_p}}\mathbf U + 2\,(\Phi z_0-\mathbf r)^\top\bar Q\,\Gamma\,\mathbf U + \text{cte} \]
\(H,\Phi,\Gamma\) são offline; online só \(\psi(x_k)\) e \(\Phi z_0\). O QP tem \(mN_p\) variáveis — o tamanho de um MPC linear comum, seja \(N=10\) ou \(N=1000\).
Algoritmo (4): Operação em Malha Fechada
flowchart TD
  A["Medir x_k<br/>(ou y_k e atrasos)"] --> B["z₀ = ψ(x_k)"]
  B --> C["Resolver QP denso<br/>H, Φ, Γ pré-calculados"]
  C --> D["U* = [u₀*, …, u*_{Np−1}]"]
  D --> E["Aplicar só u_k = u₀*"]
  E --> F["Planta: x_{k+1} = f(x_k, u_k)"]
  F --> A
Algoritmo 1 de Korda; Mezić (2018a)
Nota
O preditor é reinicializado a cada passo em \(\psi(x_k)\) — a realimentação corrige o erro acumulado do modelo linear.
Algoritmo (5): Só Temos a Saída? Atrasos
Com \(y=h(x)\) medido, observáveis só de \(y\) são pobres (se \(y=x_1\), só funções de \(x_1\)). Mas \(h(x), h(f(x)), h(f(f(x))),\dots\) também são observáveis — na prática, saídas e entradas atrasadas (Korda; Mezić, 2018a, Sec. 7.1):
\[ \zeta_k = \begin{bmatrix} y_k^\top & u_{k-1}^\top & y_{k-1}^\top & \cdots & u_{k-n_d}^\top & y_{k-n_d}^\top\end{bmatrix}^\top \in\mathbb R^{(n_d+1)p+n_dm} \]
O algoritmo é idêntico, trocando \(x\to\zeta\):
\[ \min_{A,B}\big\|\tilde Y_{\text{lift}}-A\tilde X_{\text{lift}}-B\tilde U\big\|_F, \qquad z_0=\psi(\zeta_k),\qquad \hat y = Cz \]
Se as colunas de \(\tilde X\) forem sucessivas, \(\tilde X\) tem estrutura de Hankel — a mesma ideia de imersão por atrasos do DeePC e da identificação por subespaços.
Exemplo 1: Van der Pol Forçado — Dados
\(\dot x_1 = 2x_2,\; \dot x_2 = -0.8x_1+2x_2-10x_1^2x_2+u\), integrado por RK4 com \(T_s=0{,}01\) s. Coleta: 200 trajetórias × 500 passos, \(x_0\sim\mathcal U[-1,1]^2\), \(u_k\sim\mathcal U[-1,1]\) — como no artigo.
rng, Ts = np.random.default_rng(1), 0.01
f_vdp = lambda x, u: np.array([2*x[1], -0.8*x[0] + 2*x[1] - 10*x[0]**2*x[1] + u])
def rk4(f, x, u, h=Ts):
    k1 = f(x, u); k2 = f(x + h/2*k1, u); k3 = f(x + h/2*k2, u); k4 = f(x + h*k3, u)
    return x + h/6*(k1 + 2*k2 + 2*k3 + k4)
X, Y, U = [], [], []
x = rng.uniform(-1, 1, (2, 200))                  # 200 trajetórias em paralelo
for k in range(500):
    u = rng.uniform(-1, 1, 200); xn = rk4(f_vdp, x, u)
    X.append(x); Y.append(xn); U.append(u[None]); x = xn
X, Y, U = np.hstack(X), np.hstack(Y), np.hstack(U)   # pares (x_j, u_j, x_j^+)
Exemplo 1: Lifting e Regressão
\(\psi\) = estado + 100 RBFs thin-plate \(\|x-c\|^2\log\|x-c\|\) com centros aleatórios (\(N=102\)); o DMDc é o mesmo algoritmo com \(\psi(x)=x\).
def tps(x, c):                                     # RBF thin-plate: r² log r
    r2 = ((x[:, None, :] - c[:, :, None])**2).sum(0)
    return np.where(r2 > 0, 0.5*r2*np.log(r2 + 1e-300), 0.0)
def edmdc(Xl, Yl, U):                              # equações normais: [A B] G = V
    W = np.vstack([Xl, U]); M = np.linalg.solve(W @ W.T, W @ Yl.T).T
    return M[:, :-U.shape[0]], M[:, -U.shape[0]:]
cent = rng.uniform(-1, 1, (2, 100)); lift = lambda x: np.vstack([x, tps(x, cent)])
A, B = edmdc(lift(X), lift(Y), U)                  # preditor de Koopman (N = 102)
Ad, Bd = edmdc(X, Y, U)                            # DMDc: sem lifting (N = 2)
print(f"K = {X.shape[1]} amostras;  A: {A.shape};  max|eig(A)| = {np.abs(np.linalg.eigvals(A)).max():.4f}")
K = 100000 amostras; A: (102, 102); max|eig(A)| = 1.0000Exemplo 1: Predição — Código
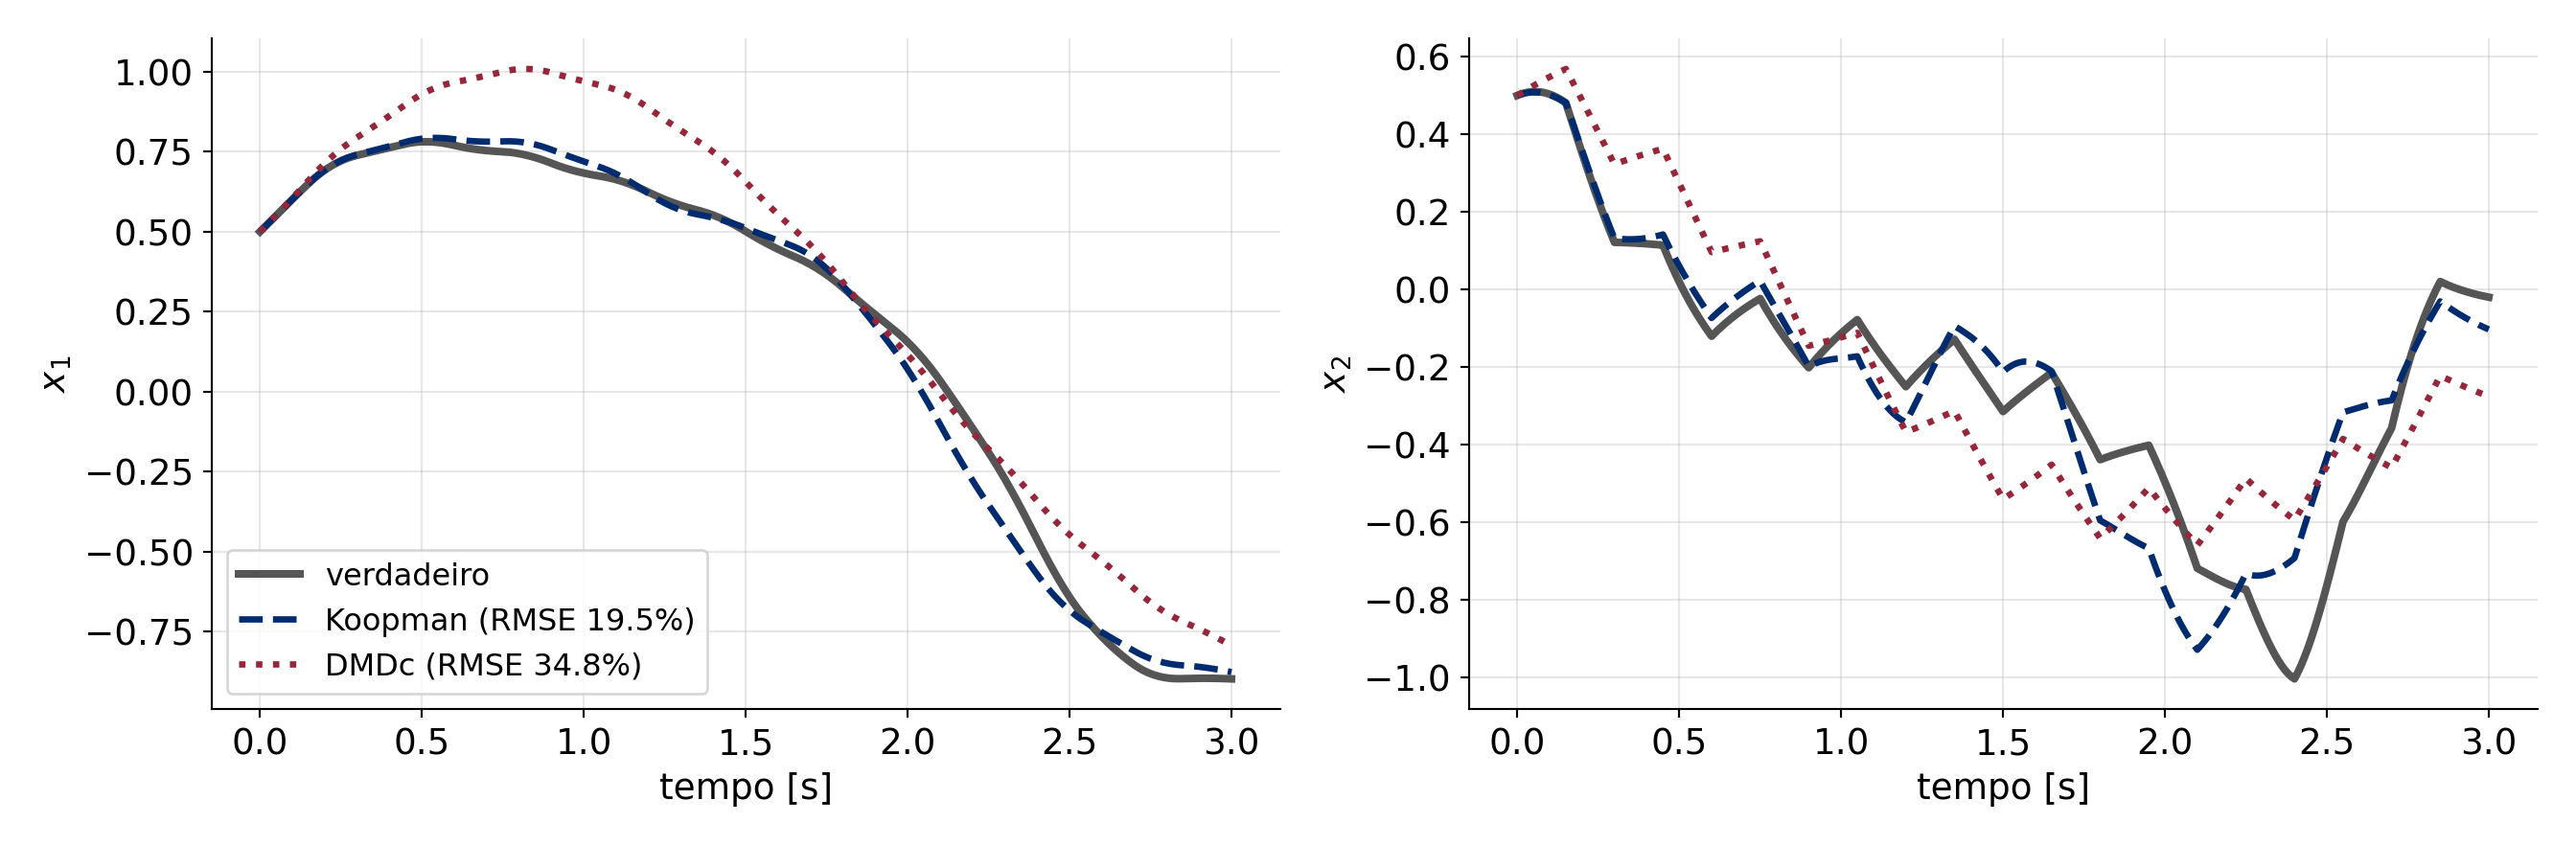
Entrada de teste: onda quadrada de amplitude 1 e período 0,3 s, horizonte de 3 s — fora do tipo de sinal usado no treino. Os três modelos recebem a mesma \(u\).
sq = lambda t: np.where(np.floor(t/0.15) % 2 == 0, 1.0, -1.0)
def predict(x0, T=300):
    """Simula a planta, o preditor de Koopman e o DMDc a partir de x0 (x0: 2 × M)."""
    xt, z, xd = x0.copy(), lift(x0), x0.copy()
    out = [[xt], [z[:2]], [xd]]
    for k in range(T):
        u = sq(k*Ts)
        xt = rk4(f_vdp, xt, u); z = A @ z + B*u; xd = Ad @ xd + Bd*u
        for o, v in zip(out, (xt, z[:2], xd)): o.append(v)
    return [np.array(o) for o in out]              # (T+1) × 2 × M
rmse = lambda p, t: 100*np.sqrt(((p - t)**2).sum((0, 1)) / (t**2).sum((0, 1)))
tr, kp, dm = predict(np.array([[0.5], [0.5]]))
Exemplo 1: Predição com Onda Quadrada
\(x_0=[0{,}5;\,0{,}5]\). O preditor é inicializado uma única vez em \(z_0=\psi(x_0)\) e evolui sozinho por 300 passos, sem nenhuma correção pela medida.
Exemplo 1: Erro Médio × Dimensão do Lifting
RMSE relativo médio em 100 condições iniciais aleatórias em \([-1,1]^2\), variando o nº de RBFs:
x0s, res = rng.uniform(-1, 1, (2, 100)), {}
for Nr in [3, 8, 23, 48, 73, 98]:                  # N = Nr + 2
    cent = rng.uniform(-1, 1, (2, Nr))
    A, B = edmdc(lift(X), lift(Y), U)
    tr, kp, dm = predict(x0s)
    res[Nr + 2] = rmse(kp, tr).mean()
msg = " · ".join(f"N={N}: {e:.1f}%" for N, e in res.items())
msg += f" · DMDc: {rmse(dm, tr).mean():.1f}%"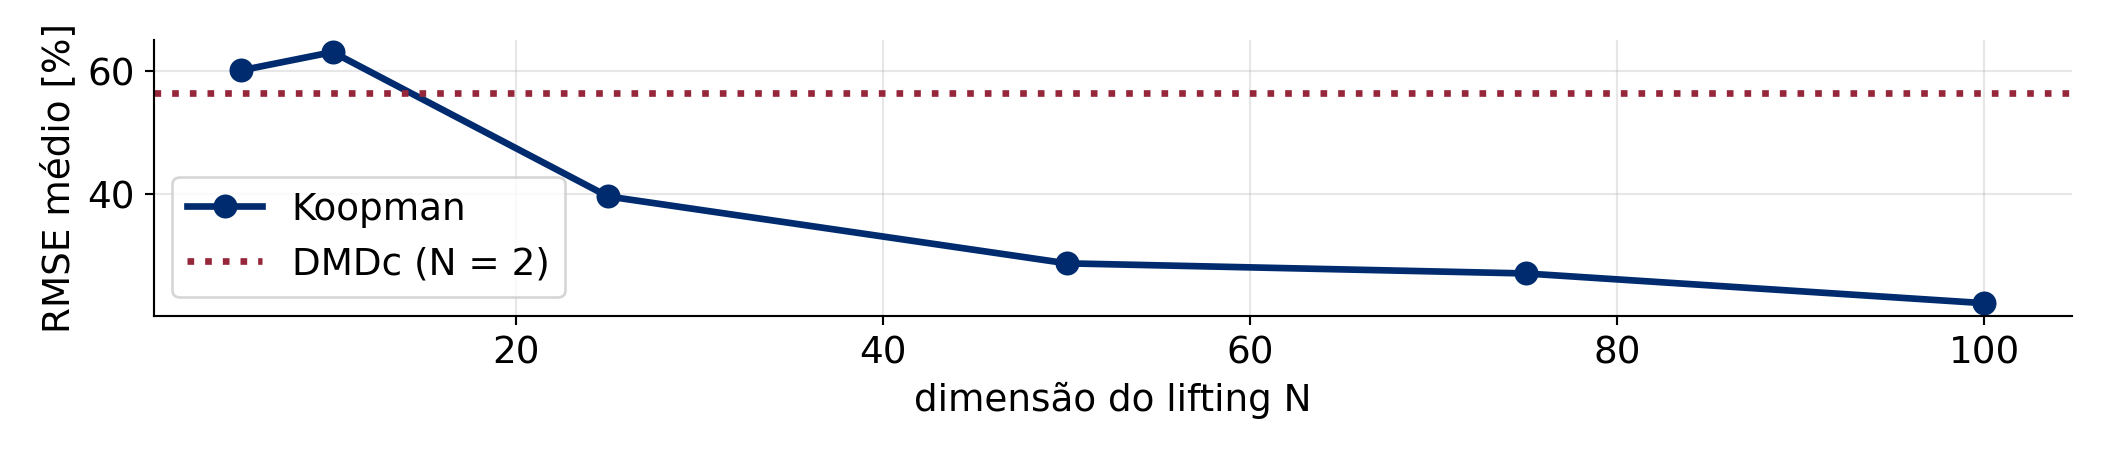
Exemplo 1: Comparação com o Artigo
Nossa reprodução: N=5: 60.1% · N=10: 63.1% · N=25: 39.6% · N=50: 28.8% · N=75: 27.1% · N=100: 22.3% · DMDc: 56.5%
Tabela 1 de Korda; Mezić (2018a) (mesmo experimento):
| Preditor | RMSE médio |
|---|---|
| Koopman (\(N=102\)) | 24,4 % |
| Linearização em \(x_0\) | \(2{,}8\cdot10^{3}\) % |
| Linearização em 0 | 912 % |
| Carleman (grau 14) | \(5\cdot10^{22}\) % |
- Com \(N=102\) reproduzimos o valor do artigo (≈ 24 %), com outra semente;
- O erro cai com \(N\), mas não monotonicamente: os centros das RBFs são aleatórios;
- Linearização e Carleman divergem — o modelo global levantado é o único que se mantém útil por 3 s de predição.
Exemplo 2: Motor CC Bilinear — Dados Entrada-Saída
Modelo escalonado do código dos autores (\(x_1\) corrente, \(x_2\) velocidade, \(u\) corrente de campo — produtos \(x_2u\) e \(x_1u\), como \(i_L\,d\) num conversor). Só medimos \(y=x_2\): \(n_d=1\), \(\zeta_k=[y_k,\,u_{k-1},\,y_{k-1}]\), \(\psi\) = \(\zeta\) + 100 RBFs (\(N=103\)).
f_mot = lambda x, u: np.array([19.10828025 - 39.3153*x[0] - 32.2293*x[1]*u,
                               -3.333333333 - 1.6599*x[1] + 22.9478*x[0]*u])
rng = np.random.default_rng(3)
x = rng.uniform(-1, 1, (2, 200)); up = rng.uniform(-1, 1, 200)
yp = x[1].copy(); x = rk4(f_mot, x, up)
Z, Zn, Uz = [], [], []
for k in range(500):
    u = rng.uniform(-1, 1, 200); xn = rk4(f_mot, x, u)
    Z.append(np.vstack([x[1], up, yp])); Zn.append(np.vstack([xn[1], u, x[1]])); Uz.append(u[None])
    yp, up, x = x[1].copy(), u, xn
Z, Zn, Uz = np.hstack(Z), np.hstack(Zn), np.hstack(Uz)   # ζ_k, ζ_{k+1}, u_k
Exemplo 2: Preditor e Forma Densa
Mesma edmdc do Exemplo 1, agora sobre \(\zeta\). A condensação monta \(\Phi\) e \(\Gamma\) (Algoritmo (3)) uma única vez, offline.
cent = rng.uniform(-1, 1, (3, 100))
A, B = edmdc(lift(Z), lift(Zn), Uz)                # Koopman, N = 103
Ad, Bd = edmdc(Z, Zn, Uz)                          # DMDc sobre ζ, N = 3

def dense(A, B, Np=100):                           # Φ (Np × N) e Γ (Np × Np), y = z[0]
    h, Ak, Phi = [], np.eye(len(A)), []
    for i in range(Np):
        h.append((Ak @ B)[0, 0]); Ak = A @ Ak; Phi.append(Ak[0])
    Gam = np.array([[h[i-j] if j <= i else 0.0 for j in range(Np)] for i in range(Np)])
    return np.array(Phi), Gam
Exemplo 2: K-MPC — Código
\(Q=1\), \(R=0{,}01\), \(N_p=100\), \(|u|\le1\). Com restrição só em \(u\), o QP denso é um mínimos quadrados com caixa: \(\min_{-1\le\mathbf U\le1}\big\|[\Gamma;\sqrt R\,I]\mathbf U-[\mathbf r-\Phi z_0;\,0]\big\|^2\).
from scipy.optimize import lsq_linear; import time
def mpc(A, B, liftf, ref, Np=100, Tsim=300):
    Phi, Gam = dense(A, B, Np); M = np.vstack([Gam, 0.1*np.eye(Np)])   # offline
    x = np.array([0.0, 0.6]); up, yp = 0.0, 0.6; x = rk4(f_mot, x, 0.0)
    ys, us, tqp = [], [], []
    for k in range(Tsim):
        z0 = liftf(np.array([[x[1]], [up], [yp]]))[:, 0]               # z0 = ψ(ζ_k)
        t0 = time.perf_counter()
        U = lsq_linear(M, np.r_[ref(k + 1 + np.arange(Np)) - Phi @ z0, np.zeros(Np)],
                       bounds=(-1, 1), method="bvls").x
        tqp.append(time.perf_counter() - t0)
        yp, up = x[1], U[0]; x = rk4(f_mot, x, U[0]); ys.append(x[1]); us.append(U[0])
    return np.array(ys), np.array(us), 1e3*np.mean(tqp)
Exemplo 2: K-MPC em Malha Fechada
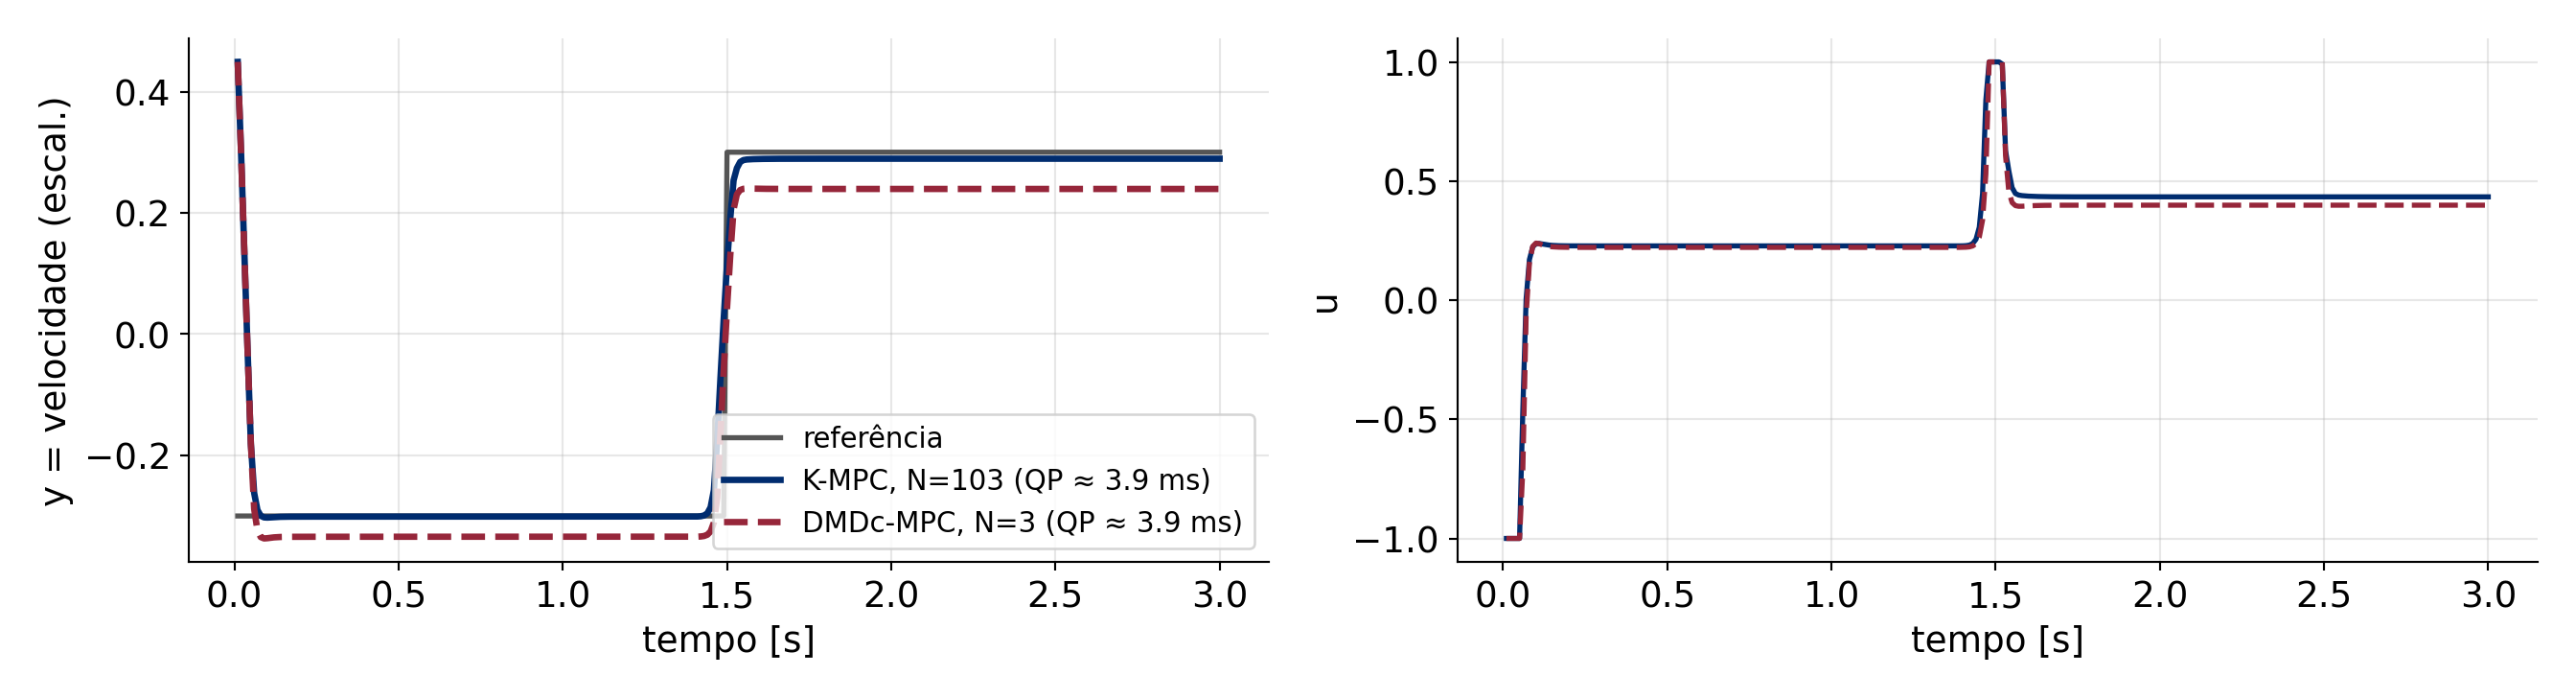
Mesmo tempo de QP (\(N_p=100\) variáveis nos dois), mas só o modelo levantado captura o ganho que varia com o ponto de operação — o DMDc deixa offset.
Ponte: Da Predição à Validação
O que levamos deste bloco
- Preditor linear via EDMD com \(u\) não levantado \(\Rightarrow\) MPC = QP;
- Custo online independente de \(N\) (forma densa);
- Funciona com só entrada-saída via atrasos;
- Motor bilinear \(\approx\) modelo médio de boost/buck-boost (\(x\cdot d\)).
O que ainda está em aberto
- Sem garantia de estabilidade/recursividade — o modelo é aproximado;
- Offset residual: ação integral ou estimação de perturbação;
- Escolha do dicionário (\(N\), centros) e da excitação dos dados;
- Preditores bilineares \(z^+=Az+(Bz)u\) são mais fiéis, mas saem do QP.
Próximo bloco — Validação: como medir se o preditor serve para controle? Erro em horizonte \(N_p\) versus erro de um passo, dados de validação fora da distribuição de treino, e comparação com DeePC no mesmo conversor.
Referências
KORDA, Milan; MEZIĆ, Igor. Linear Predictors for Nonlinear Dynamical Systems: Koopman Operator Meets Model Predictive Control. Automatica, v. 93, p. 149–160, a2018.
KORDA, Milan; MEZIĆ, Igor. On Convergence of Extended Dynamic Mode Decomposition to the Koopman Operator. Journal of Nonlinear Science, v. 28, n. 2, p. 687–710, b2018.
PROCTOR, Joshua L.; BRUNTON, Steven L.; KUTZ, J. Nathan. Dynamic Mode Decomposition with Control. SIAM Journal on Applied Dynamical Systems, v. 15, n. 1, p. 142–161, 2016.
Encerramento
Prof. Dr. Raphael Teixeira
Universidade Federal do Pará