K ótimo: 0.9583Q-Learning vs. LQR
Controle Baseado em Dados
Prof. Dr. Raphael Teixeira
Universidade Federal do Pará
Recapitulando
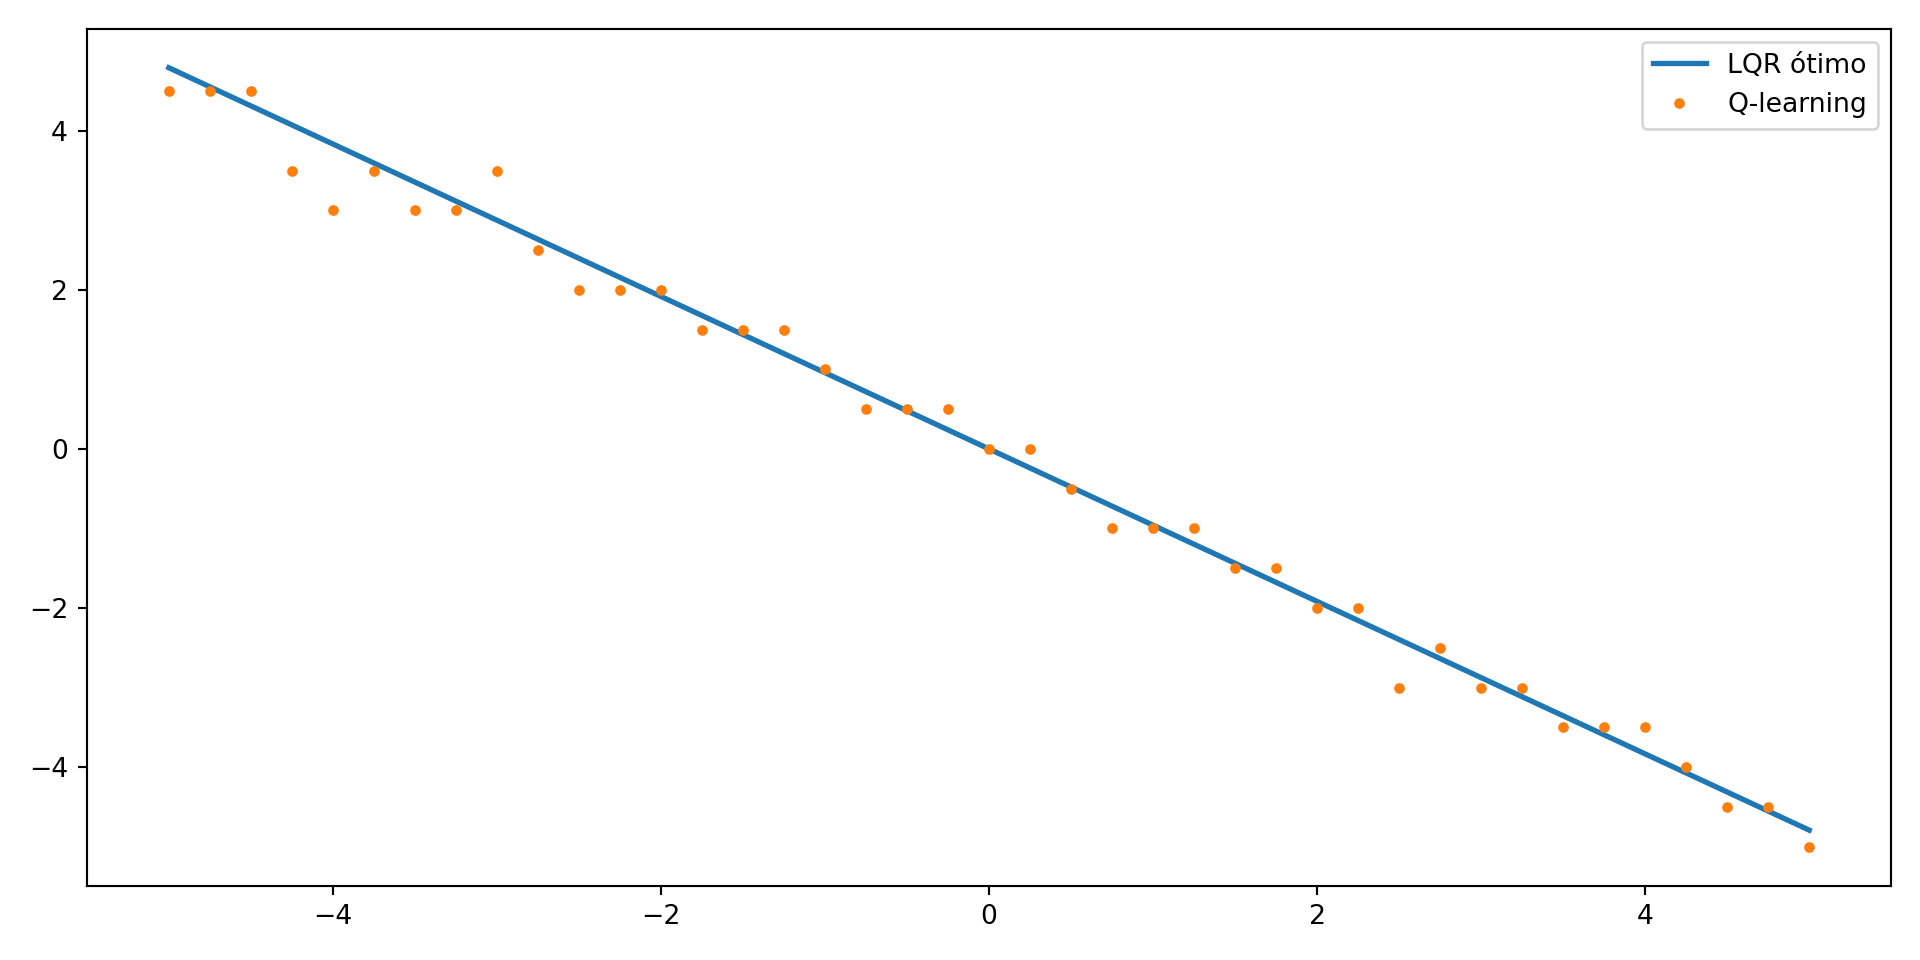
Q-learning aprende \(Q^\ast(s,a)\) por tentativa e erro. Aqui, um LQR escalar — solução ótima conhecida em forma fechada. Q-learning tabular encontra a mesma resposta?
\[ x_{k+1} = a x_k + b u_k \qquad \text{custo: } x_k^2 + \rho\, u_k^2 \]
Solução Ótima: Riccati
Custo ótimo \(V^\ast(x)=Px^2\), política ótima linear \(u^\ast(x)=-Kx\):
\[ P = 1 + \gamma a^2 P - \frac{(\gamma a b P)^2}{\rho + \gamma b^2 P} \qquad K = \frac{\gamma a b P}{\rho + \gamma b^2 P} \]
Resolvemos \(P\) por ponto fixo — o que a programação dinâmica faria.
Python — Riccati
Python — Ambiente Discretizado
Python — Laço de Q-Learning
alpha, n_ep, steps = 0.1, 4000, 30
for ep in range(n_ep):
    x = rng.uniform(-5, 5)
    eps = max(0.1, 1 - ep/2000)
    for t in range(steps):
        si = disc(x, x_grid)
        ai = rng.integers(len(u_grid)) if rng.random() < eps else np.argmax(Q[si])
        u = u_grid[ai]
        custo = x**2 + rho*u**2
        x2 = np.clip(a*x + b*u, -5, 5)
        Q[si,ai] += alpha*(-custo + gamma*np.max(Q[disc(x2,x_grid)]) - Q[si,ai])
        x = x2
Recompensa \(=-\text{custo}\).
Resultado — Política vs. Ótima
K aprendido: 0.9540 | K ótimo: 0.9583Diferença menor que 1% entre o ganho aprendido e o ótimo analítico.
Resultado — Gráfico
Discussão
- Q-learning redescobre a política ótima sem conhecer \(a,b,\rho\);
- A tabela cresce exponencialmente com a dimensão do estado;
- Alta dimensão: redes neurais (DDPG, PPO) (Lillicrap et al., 2016; Schulman et al., 2017);
- Estrutura conhecida (linear-quadrático): a solução analítica é mais barata — RL vale mais sem modelo (Recht, 2019).
Referências
LILLICRAP, Timothy P. et al. Continuous Control with Deep Reinforcement Learning. International Conference on Learning Representations (ICLR), 2016.
RECHT, Benjamin. A Tour of Reinforcement Learning: The View from Continuous Control. Annual Review of Control, Robotics, and Autonomous Systems, v. 2, p. 253–279, 2019.
SCHULMAN, John et al. Proximal Policy Optimization Algorithms. arXiv preprint arXiv:1707.06347, 2017.
Encerramento
Prof. Dr. Raphael Teixeira
Universidade Federal do Pará