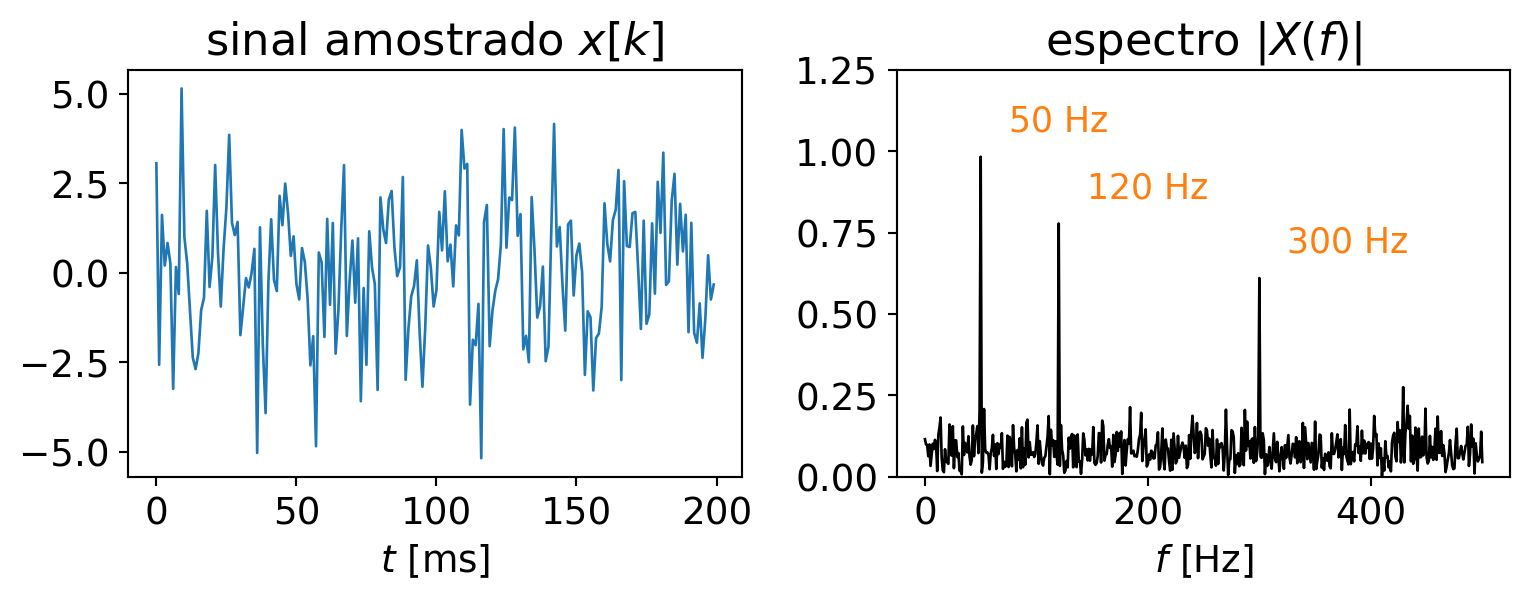
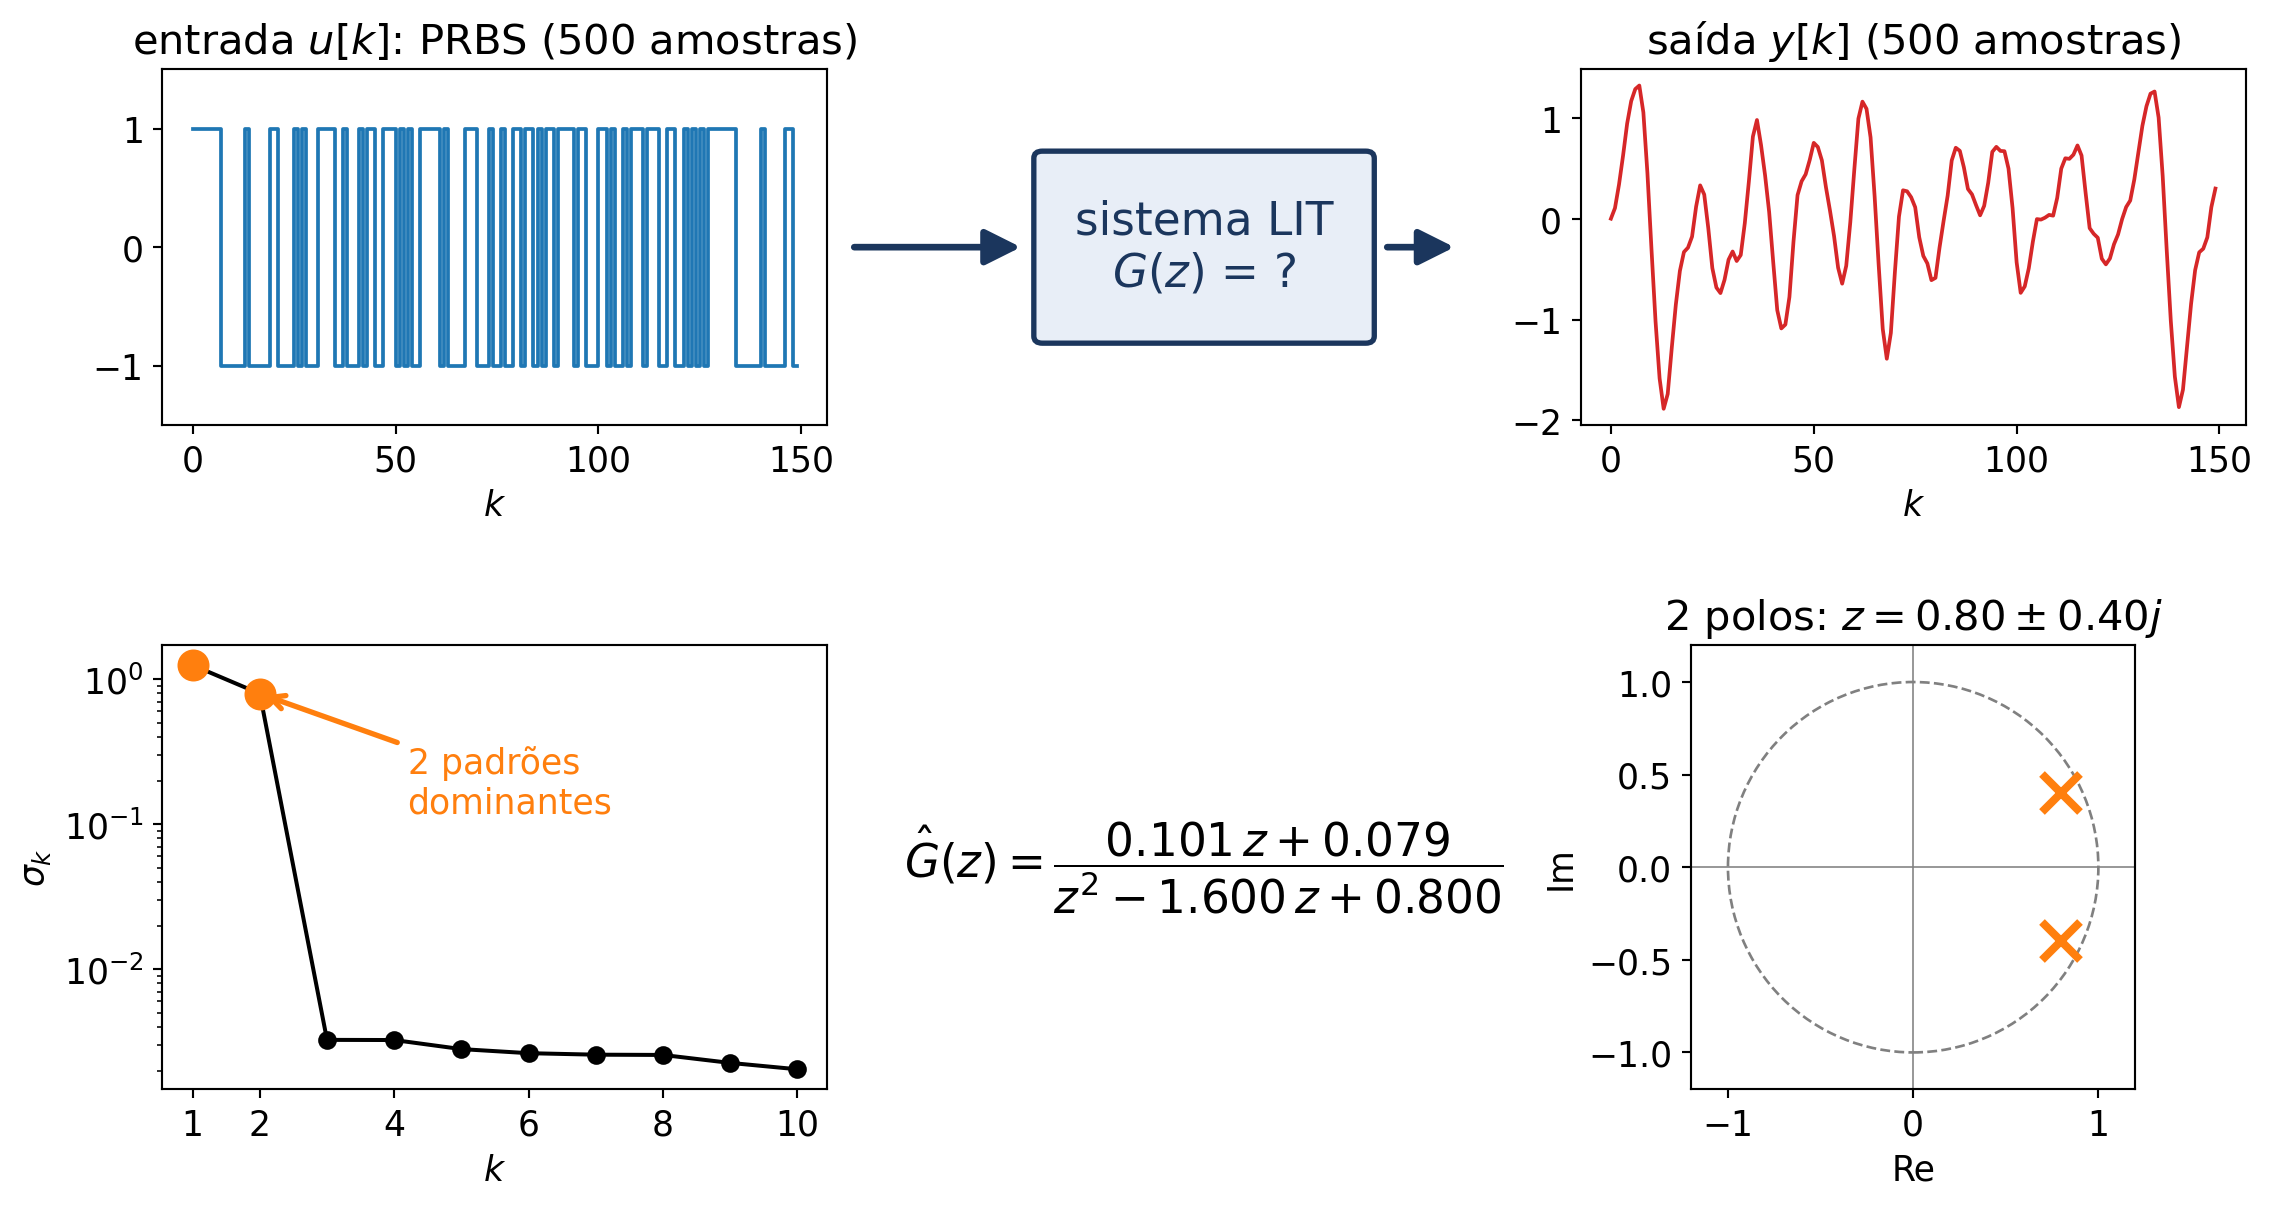
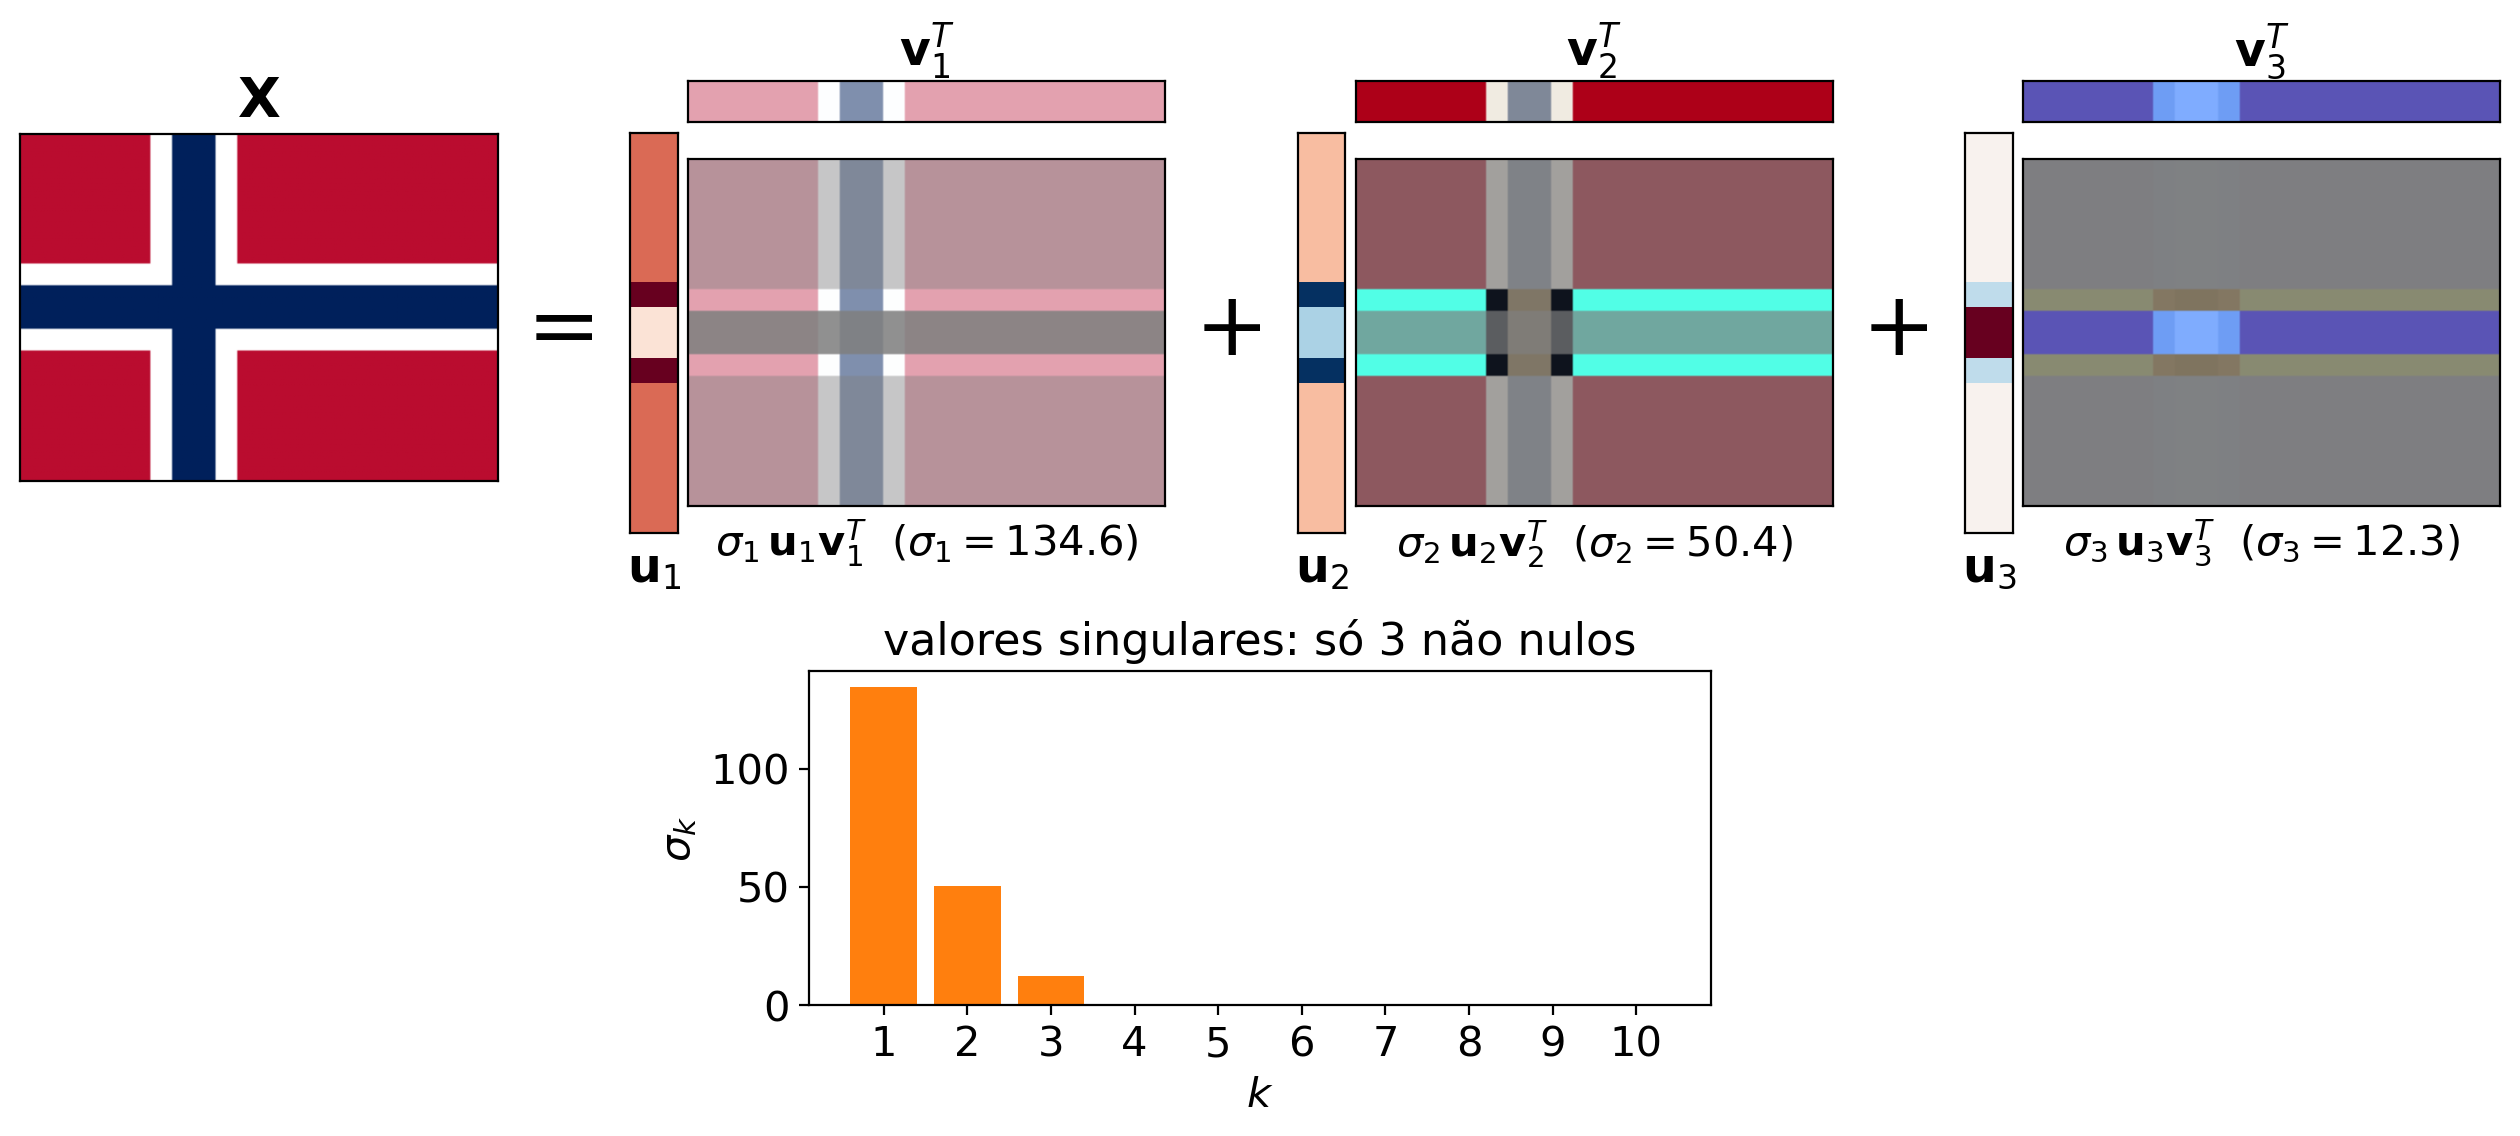
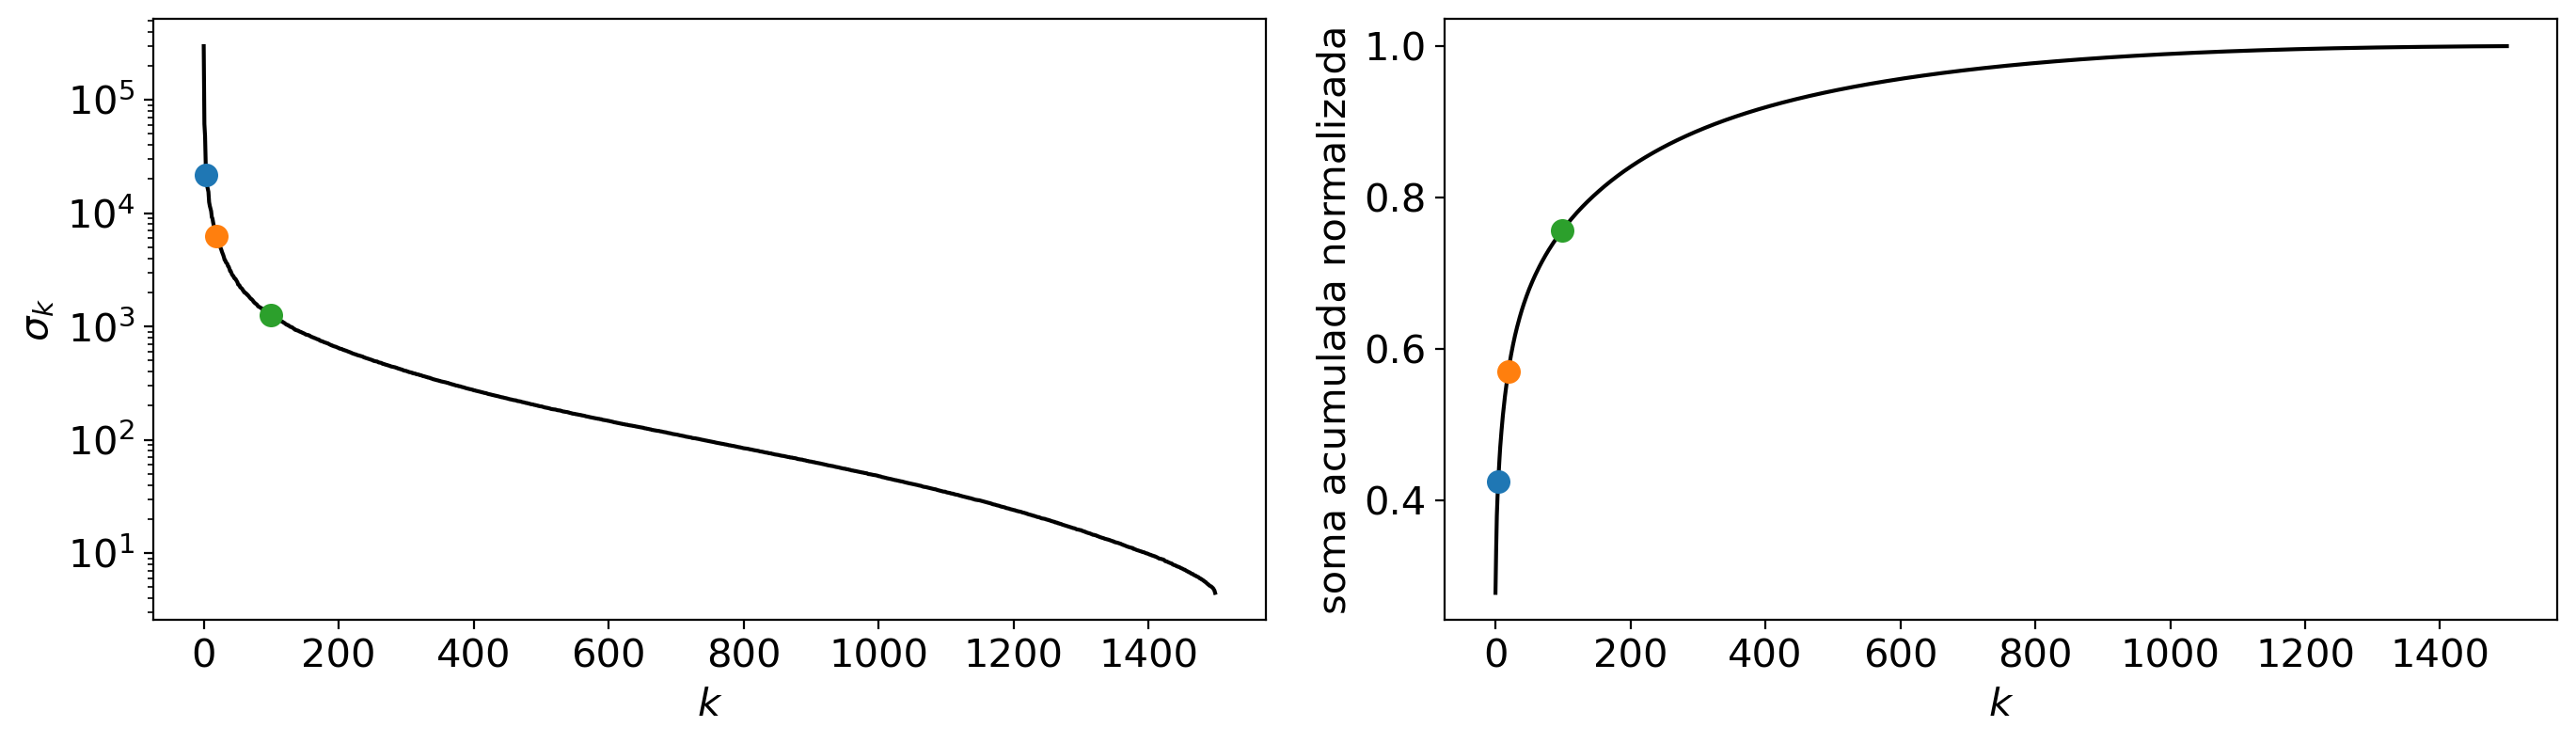
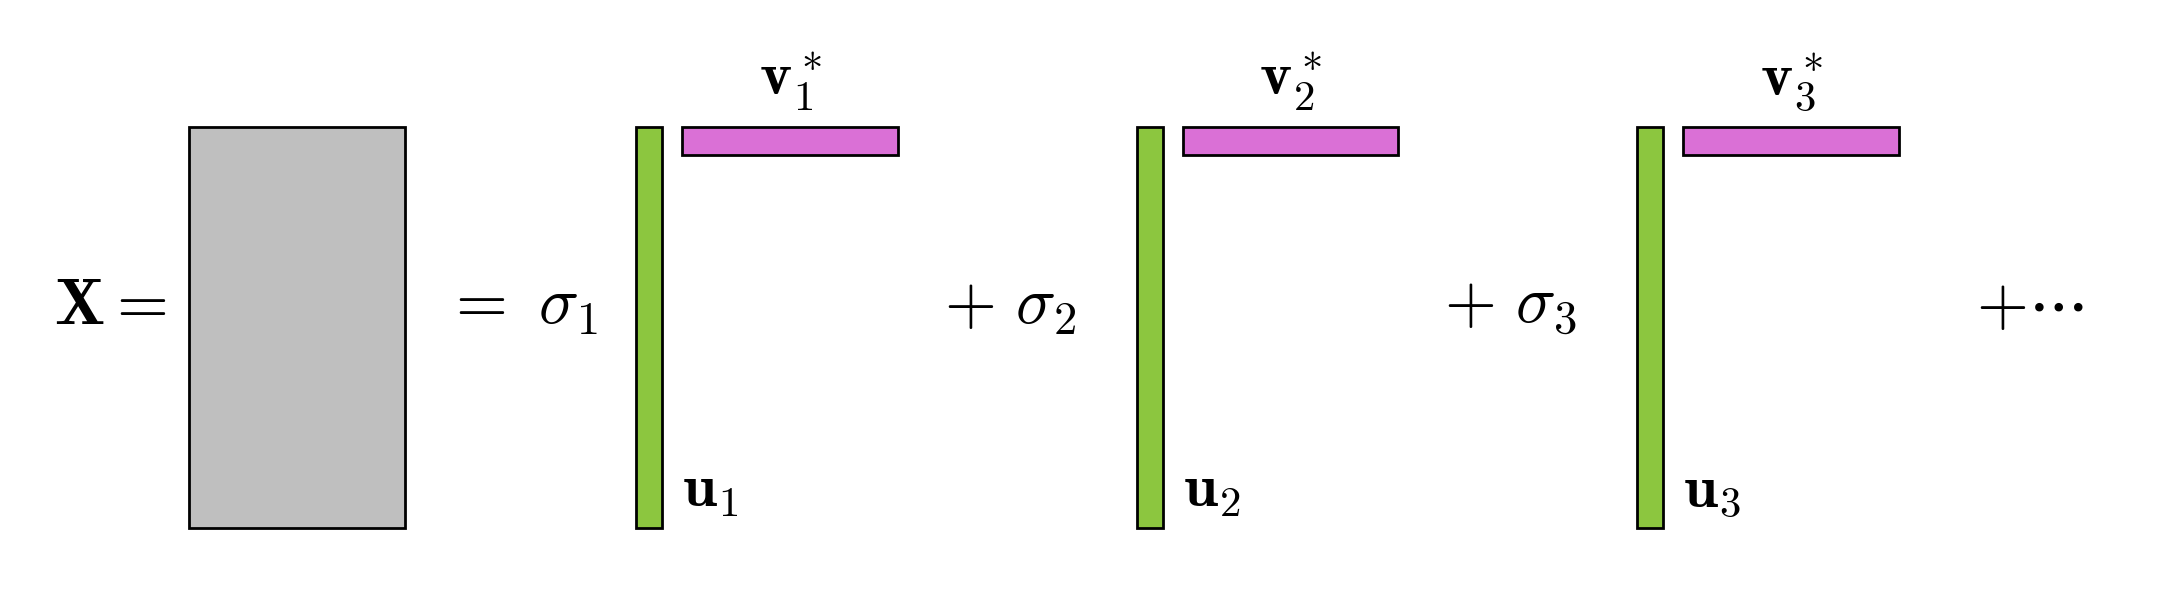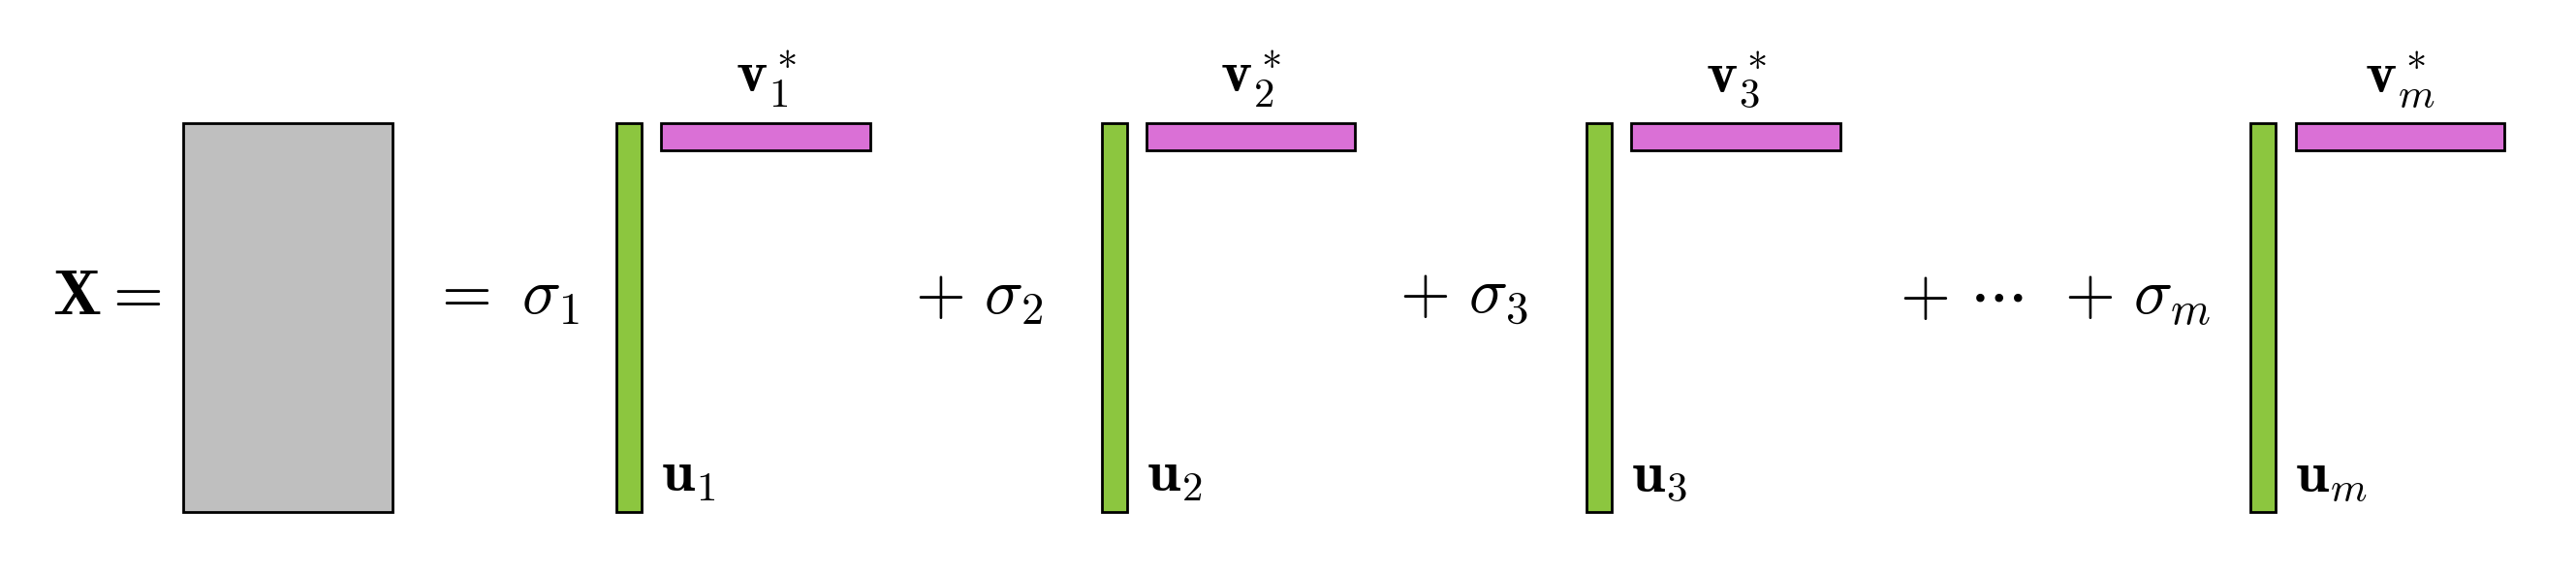Centenas de amostras, mas apenas dois padrões dominantes: os padrões são os seus dois polos.
A matriz de dados
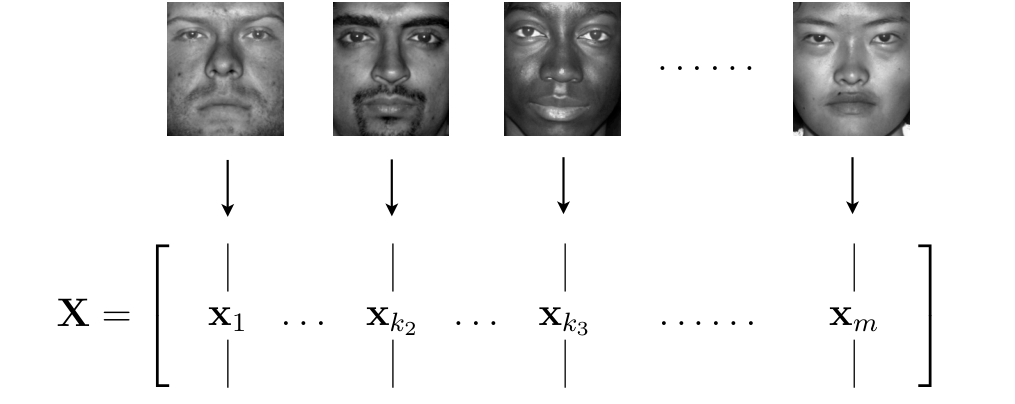
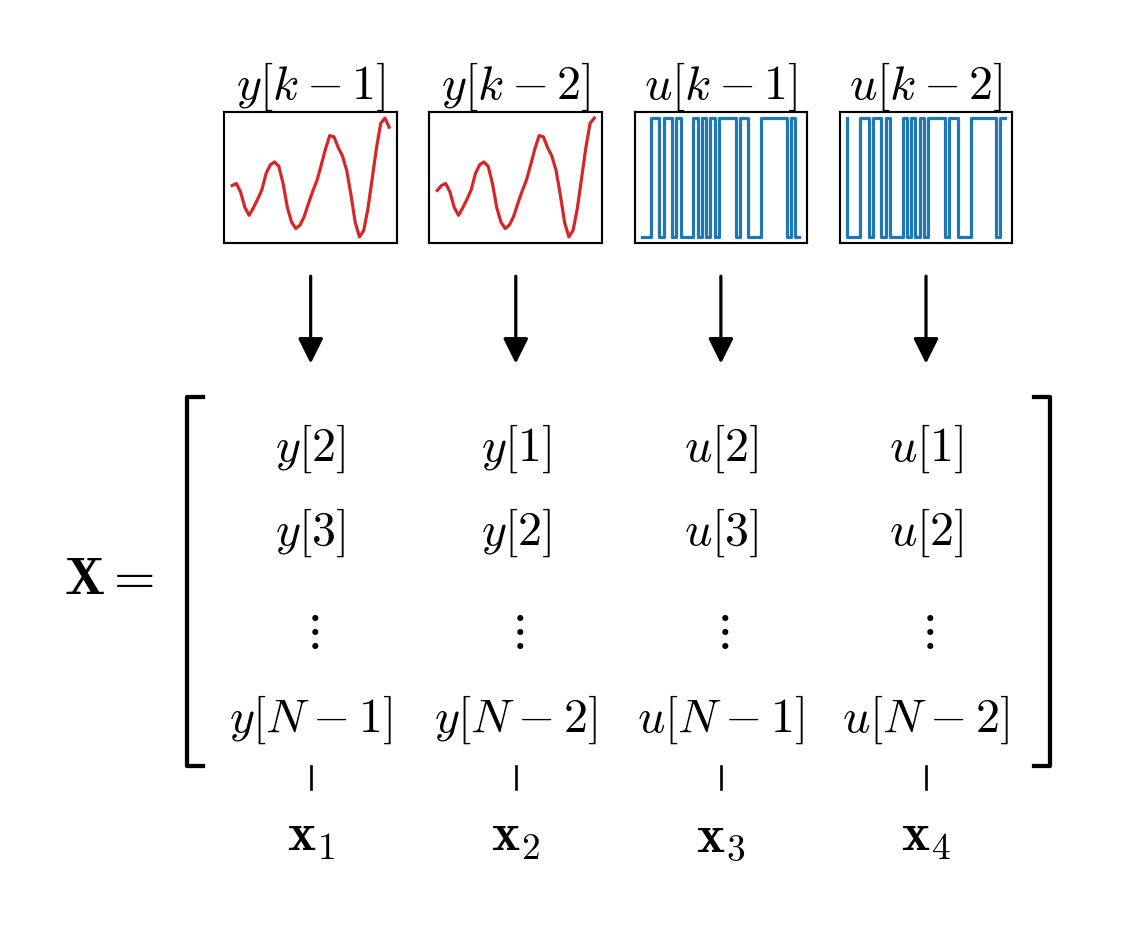
Cada coluna de \(\mathbf{X} = [\mathbf{x}_1 \ \cdots \ \mathbf{x}_m] \in \mathbb{C}^{n \times m}\) é um conjunto de medições: uma imagem, ou amostras de entrada e saída de um sistema.
As colunas são snapshots\(\mathbf{x}_k = \mathbf{x}(k\Delta t)\); em geral \(n \gg m\): uma matriz alta e estreita.
Uma matriz como soma de padrões
Cada padrão é uma coluna\(\mathbf{u}_k\) vezes uma linha\(\mathbf{v}_k^T\), com um peso\(\sigma_k\) (valor singular).
Da soma de padrões à SVD
Para \(\mathbf{X} \in \mathbb{C}^{n \times m}\) com \(n \ge m\), a matriz é uma soma de até \(m\) padrões:
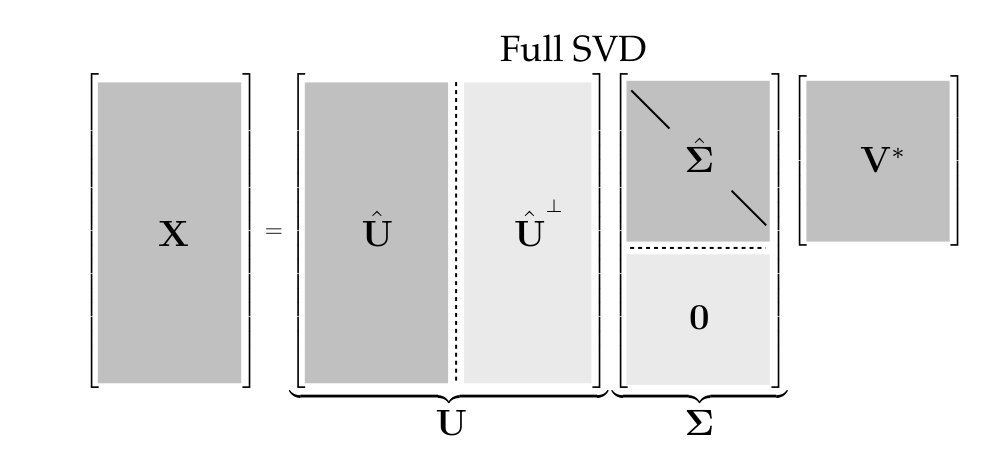
\(\mathbf{U}\) (\(n \times n\)): suas colunas \(\mathbf{u}_k\) são os padrões ao longo das colunas de \(\mathbf{X}\).
\(\boldsymbol{\Sigma}\) (\(n \times m\)): diagonal com os valores singulares de \(\mathbf{X}\), \(\sigma_1 \ge \sigma_2 \ge \cdots \ge \sigma_m \ge 0\) — os pesos dos padrões;
\(\mathbf{V}^*\) (\(m \times m\)): suas linhas \(\mathbf{v}_k^*\) são os padrões ao longo das linhas de \(\mathbf{X}\).
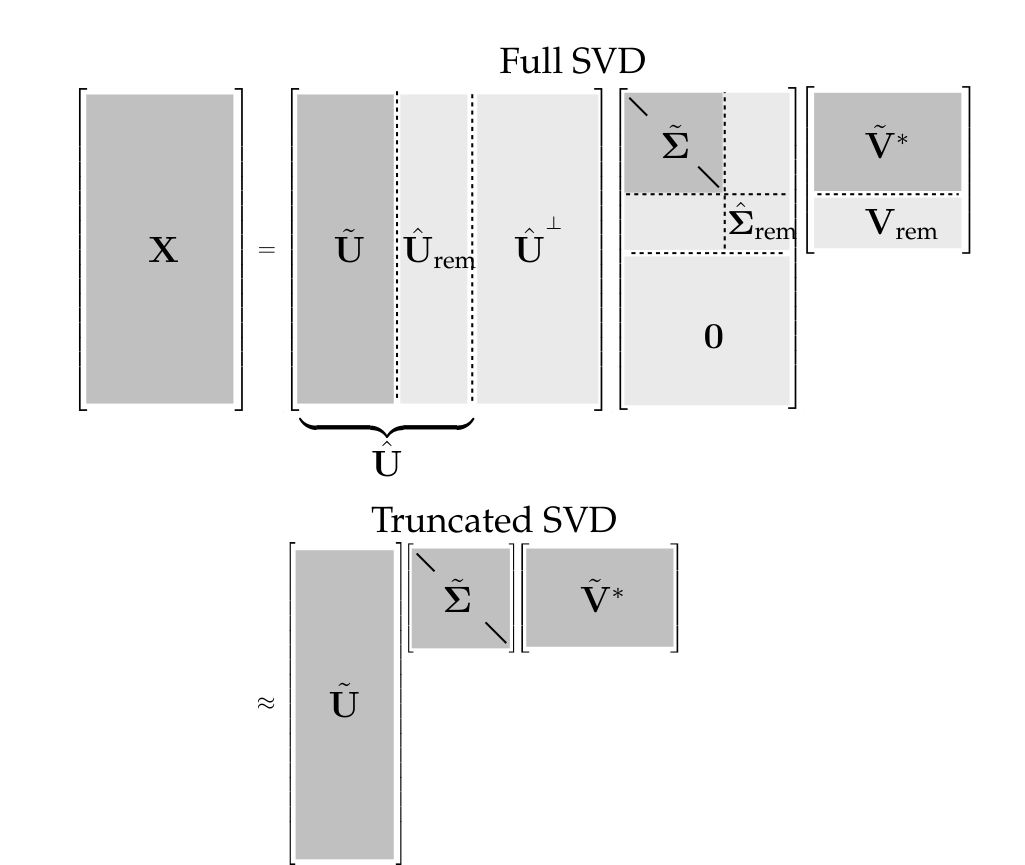
As colunas de \(\mathbf{U}\) além da \(m\)-ésima (\(\mathbf{\hat{U}}^\perp\)) multiplicam só zeros de \(\boldsymbol{\Sigma}\).
Diferente da FFT, que usa uma base fixa (senoides), as bases \(\mathbf{U}\) e \(\mathbf{V}\) da SVD são extraídas dos próprios dados, sem conhecimento prévio do sistema.
A decomposição SVD
Definição
Toda matriz \(\mathbf{X} \in \mathbb{C}^{n \times m}\) pode ser escrita como \[
\mathbf{X} = \mathbf{U} \boldsymbol{\Sigma} \mathbf{V}^*
\] com \(\mathbf{U}\) (\(n \times n\)) e \(\mathbf{V}\) (\(m \times m\)) unitárias e \(\boldsymbol{\Sigma}\) (\(n \times m\)) diagonal, \(\sigma_k \ge 0\).
Posto de \(\mathbf{X}\) = número de \(\sigma_k \neq 0\).
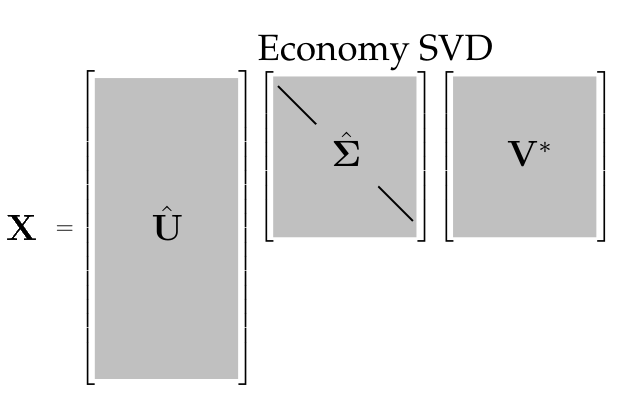
Se \(n \ge m\), só as \(m\) primeiras colunas de \(\mathbf{U}\) multiplicam valores não nulos: \[
\mathbf{X} = \mathbf{\hat{U}}\, \boldsymbol{\hat{\Sigma}}\, \mathbf{V}^*
\] a SVD econômica.
Computando a SVD
Na prática, basta uma linha: a SVD vem pronta do LAPACK, base do NumPy e do MATLAB.
\(\mathbf{\tilde{U}}\), \(\mathbf{\tilde{V}}\): as \(r\) primeiras colunas de \(\mathbf{U}\), \(\mathbf{V}\); \(\boldsymbol{\tilde{\Sigma}}\): o bloco \(r \times r\).
Se \(r <\) posto de \(\mathbf{X}\), \(\mathbf{\tilde{X}}\) só aproxima\(\mathbf{X}\).
\(\mathbf{\tilde{U}}\) leva das medições (dimensão \(n\)) aos padrões (dimensão \(r\)).
Teorema de Eckart–Young
Resultado de Schmidt (o de Gram–Schmidt), redescoberto por Eckart e Young:
Teorema 1.1 (Eckart–Young)
A melhor aproximação de posto \(r\) de \(\mathbf{X}\), no sentido de mínimos quadrados, é a SVD truncada de posto \(r\): \[
\underset{\mathbf{\tilde{X}},\ \text{s.a.}\ \operatorname{posto}(\mathbf{\tilde{X}}) = r}{\operatorname{argmin}} \ \big\| \mathbf{X} - \mathbf{\tilde{X}} \big\|_F = \mathbf{\tilde{U}} \boldsymbol{\tilde{\Sigma}} \mathbf{\tilde{V}}^*
\]
O resíduo é a soma dos termos descartados, \(\mathbf{X} - \mathbf{\tilde{X}} = \sum_{k=r+1}^{m} \sigma_k \mathbf{u}_k \mathbf{v}_k^* = \mathbf{U}_{\text{rem}} \boldsymbol{\Sigma}_{\text{rem}} \mathbf{V}_{\text{rem}}^*\). Como \(\|\mathbf{A}\|_F^2 = \operatorname{tr}(\mathbf{A}^*\mathbf{A})\) e \(\mathbf{U}_{\text{rem}}^*\mathbf{U}_{\text{rem}} = \mathbf{V}_{\text{rem}}^*\mathbf{V}_{\text{rem}} = \mathbf{I}\), as bases ortonormais não alteram a norma: \(\|\mathbf{X} - \mathbf{\tilde{X}}\|_F^2 = \|\boldsymbol{\Sigma}_{\text{rem}}\|_F^2 = \sigma_{r+1}^2 + \cdots + \sigma_m^2\).
Como esse erro escala com a magnitude de \(\mathbf{X}\), costuma ser mais útil o erro relativo\(\;\big\| \mathbf{X} - \mathbf{\tilde{X}} \big\|_F^2 \,/\, \|\mathbf{X}\|_F^2 \;\) (1.8):
Sinais medidos (tensões, correntes): (1.8) é a fração da energia que falta (\(\|\mathbf{X}\|_F^2\) = soma dos quadrados das amostras).
Dados com média subtraída: é a fração da variância que falta (PCA, §1.5).
Aproximação ótima na norma 2
A SVD truncada também é ótima na norma 2 (norma espectral), induzida pela norma 2 de vetores:
Nessa norma, o erro é ainda mais simples: \[
\big\| \mathbf{X} - \mathbf{\tilde{X}} \big\|_2 = \sigma_{r+1}. \qquad (1.10)
\]
Basta expandir o resíduo, \[
\mathbf{X} - \mathbf{\tilde{X}} = \sum_{k=r+1}^{m} \sigma_k \mathbf{u}_k \mathbf{v}_k^*, \qquad (1.11)
\] e usar a ortonormalidade dos \(\mathbf{v}_k\): o máximo de \(\|(\mathbf{X} - \mathbf{\tilde{X}})\mathbf{v}\|_2\) sobre vetores unitários é \(\sigma_{r+1}\), atingido em \(\mathbf{v} = \mathbf{v}_{r+1}\).
rng(0);X=randn(200,50);[U,S,V] =svd(X,'econ');s=diag(S);% valores singulares (vetor)r=10;Xr=U(:,1:r)*S(1:r,1:r)*V(:,1:r)';% SVD truncada de posto r (1.5)disp([norm(X-Xr,'fro')^2,sum(s(r+1:end).^2)]) % (1.7)disp([norm(X-Xr,2),s(r+1)]) % (1.10)
Os índices em Python começam em 0: S[r] é \(\sigma_{r+1}\) e S[r:] são \(\sigma_{r+1}, \dots, \sigma_m\); no MATLAB, s(r+1) e s(r+1:end).
Exemplo: compressão de imagem
Uma imagem em tons de cinza é uma matriz real \(\mathbf{X} \in \mathbb{R}^{n \times m}\) (\(n\) pixels na vertical, \(m\) na horizontal). Aqui, a mesma foto do livro: o cachorro Mordecai (\(2000 \times 1500\) pixels).
A = plt.imread("imgs/dog.jpg") # foto colorida (RGB)X = np.mean(A, axis=-1) # RGB -> tons de cinzan, m = X.shapeU, S, VT = np.linalg.svd(X, full_matrices=False) # SVD econômicaaproxima =lambda r: U[:, :r] @ np.diag(S[:r]) @ VT[:r, :] # SVD truncada (1.5)armazenamento =lambda r: r * (n + m +1) / (n * m) # fração guardada
A=imread('imgs/dog.jpg');% foto colorida (RGB)X=mean(double(A),3);% RGB -> tons de cinza[n,m] =size(X);[U,S,V] =svd(X,'econ');s=diag(S);% SVD econômicaforr= [520100] % SVD truncada (1.5) para vários postosXapprox=U(:,1:r)*S(1:r,1:r)*V(:,1:r)';figure,imagesc(Xapprox),axisoff,colormapgraytitle(sprintf('r = %d (%.1f%% dos dados)',r,100*r*(n+m+1)/(n*m)))endfigure,subplot(1,2,1),semilogy(s,'k') % valores singularessubplot(1,2,2),plot(cumsum(s)/sum(s),'k') % soma acumulada
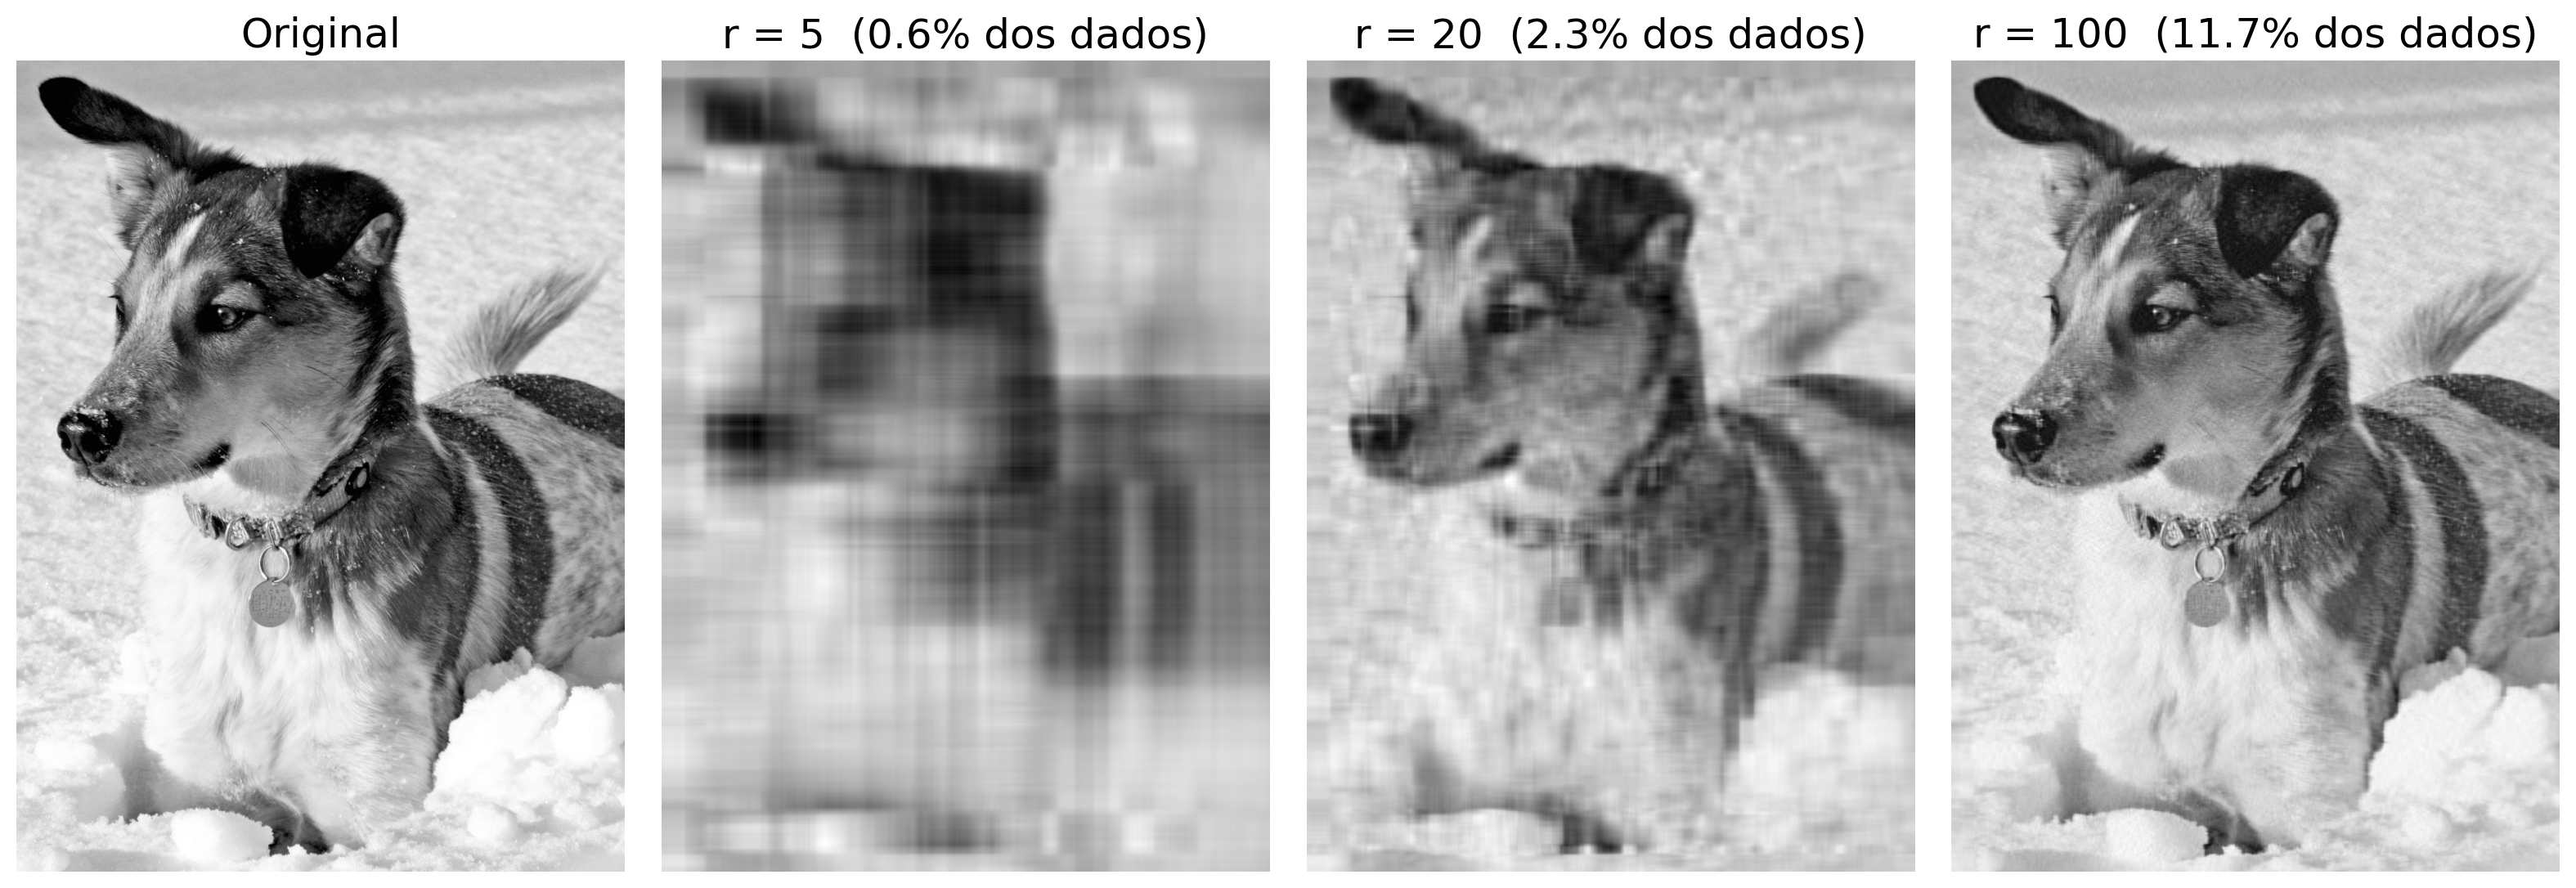
Guardar \(\mathbf{\tilde{U}}\), \(\boldsymbol{\tilde{\Sigma}}\) e \(\mathbf{\tilde{V}}\) exige \(r(n + m + 1)\) números, contra \(nm\) da imagem original: a truncação é uma compressão.
Imagem reconstruída para vários postos \(r\)
Com \(r = 5\) só se reconhecem as grandes regiões claras e escuras; com \(r = 100\) a imagem já é visualmente próxima da original.