DeePC

Três Exemplos Comentados, do QP Canônico ao QP Reduzido

Prof. Dr. Raphael Teixeira

Universidade Federal do Pará

Objetivos da Aula

  • Deixar de ver o DeePC como “fórmula abstrata” e passar a ver como código que roda, passo a passo;
  • Acompanhar três roteiros MATLAB progressivamente mais realistas, cada um reescrito aqui em Python e executado ao vivo;
  • Entender, em cada exemplo, o que muda e por quê: da formulação canônica ao desafio do tempo real e à redução do problema de otimização.

Nota

Pré-requisito: DeePC — Introdução (Lema de Willems, formulação básica) e DeePC com Ruído (regularização de Tikhonov). Esta aula não repete essa teoria — ela mostra essa teoria em código.

Recapitulando o DeePC

A Ideia em Uma Frase

DeePC resolve, a cada instante, um problema de controle preditivo usando diretamente uma trajetória de dados \((u_d, y_d)\) — sem nunca estimar \((A,B,C,D)\) — porque, pelo Lema Fundamental de Willems, essa trajetória já contém toda a informação sobre o comportamento do sistema (Coulson; Lygeros; Dörfler, 2019a; Willems et al., 2005).

Hoje, essa ideia vira código: em nenhum dos três exemplos a lei de controle lê as matrizes \((A,B,C)\) da planta — elas só existem para gerar os dados e simular a planta no laço fechado.

A Receita, em Quatro Passos

  1. Coletar dados: aplicar uma entrada \(u_d\) persistentemente excitante e registrar a saída \(y_d\) — uma vez, off-line;
  2. Montar as matrizes de Hankel de \(u_d,y_d\) e particioná-las em blocos “passado” (\(U_p,Y_p\)) e “futuro” (\(U_f,Y_f\));
  3. Resolver um QP: encontrar \(g\) tal que o passado combine com o histórico recente \((u_{\text{ini}}, y_{\text{ini}})\) e o futuro predito \(y=Y_fg\) siga a referência, com o menor esforço \(u=U_fg\);
  4. Aplicar só o primeiro passo de \(u\), deslizar a janela \((u_{\text{ini}}, y_{\text{ini}})\) e repetir — horizonte deslizante, como em qualquer MPC.

Os três exemplos de hoje implementam exatamente esses quatro passos — a diferença está em como cada passo é feito.

Notação que Vai Aparecer no Código

Símbolo Significado Papel no código
\(T\) amostras do experimento off-line tamanho de ud,yd
\(T_{\text{ini}}\) janela do “estado inicial” (\(\geq\) ordem \(n\) da planta) linhas de Up,Yp
\(N\) horizonte de predição linhas de Uf,Yf
\(L=T_{\text{ini}}+N\) profundidade da Hankel hankel_mat(w, L)
\(Q,R\) peso do erro de saída / esforço de controle custo do QP
\(\lambda_g,\lambda_y\) regularização de \(g\) / penalidade da folga \(\sigma_y\) termos extras em \(H\)
\(u_{\min},u_{\max}\) restrição de entrada inequação do QP
\(g\) combinação linear das colunas de Hankel variável de decisão

Panorama dos Três Exemplos

Três Roteiros, um Fio Condutor

deepc_exemplo.m deepc_exemplo2.m deepc_exemplo_v3.m
Planta 2ª ordem discreta simples 2ª ordem contínua subamortecida (\(T_s=2\,\)ms) a mesma do exemplo 2
Variáveis de decisão \(n_G=T-L+1\approx 182\) \(n_G\approx 265\) reduzido para \(r=2L\approx 72\)
Novidade formulação canônica: folga \(\sigma_y\) + restrição de entrada checagem formal de excitação persistente; mede \(t_{QP}\) vs. \(T_s\) reparametriza \(g\) por SVD; elimina \(\sigma_y\) analiticamente
Pergunta que responde “Como funciona o DeePC, de fato?” “Isso roda em tempo real?” “Como fazer rodar mais rápido?”

Não são três técnicas diferentes — é o mesmo problema, refinado em três passadas: primeiro correto, depois realista, depois eficiente.

MATLAB → Python, sem Perder Nada

Os três .m originais usam quadprog (Optimization Toolbox). Aqui, reproduzimos a mesma matemática — mesmo \(H\), \(A_{eq}\), \(A_{in}\) — e resolvemos com scipy.optimize.minimize (QP genérico via SLSQP), só para executar ao vivo no slide sem depender de MATLAB. Os números vão ser próximos, não idênticos, aos dos scripts originais.

Exemplo 1 — DeePC Canônico

A Planta que o Controlador Nunca Vê

Uma planta de 2ª ordem, discreta, com ganho DC unitário — “desconhecida” no sentido de que só serve para gerar dados e simular a malha fechada:

import numpy as np
NAVY, BLUE, GRAY, ORANGE, GREEN = "#1B365D", "#4A6FA5", "#6C757D", "#E65100", "#2E7D32"

rng = np.random.default_rng(1)
A = np.array([[0.9, 0.2], [-0.2, 0.9]])
B = np.array([[0.1], [0.2]])
C = np.array([[1.0, 0.0]])
sig_n = 0.01                       # desvio padrão do ruído de medição

Nota

A lei de controle do DeePC nunca vai usar A, B, C diretamente — só para gerar ud,yd (passo 1) e para simular x = A@x + B@u no laço fechado.

Parâmetros do Problema

T, Tini, N = 200, 4, 15            # dados off-line / passado / horizonte futuro
L = Tini + N
Q, R = 10.0, 0.1                   # peso: erro de saída / esforço de controle
lam_g, lam_y = 1.0, 1e4            # regularização de g / penalidade da folga
umin, umax = -1.5, 1.5             # restrição de entrada
  • \(T_{\text{ini}}=4 \geq n=2\) (ordem da planta): a janela precisa ser grande o bastante para fixar o “estado” implícito;
  • \(\lambda_y=10^4 \gg \lambda_g=1\): a folga \(\sigma_y\) deve ser quase nula em condições normais — ela existe só para absorver ruído (Coulson; Lygeros; Dörfler, 2019b; Huang et al., 2021);
  • \(u_{\min},u_{\max}\): a única restrição física deste exemplo.

Passo 1 — Coleta de Dados

def hankel_mat(w, L):
    w = np.atleast_2d(w)
    if w.shape[0] == 1: w = w.T
    Tt, q = w.shape
    cols = Tt - L + 1
    Hm = np.zeros((L*q, cols))
    for j in range(cols):
        Hm[:, j] = w[j:j+L, :].T.reshape(-1)
    return Hm

ud = rng.standard_normal(T)        # entrada aleatória (persistentemente excitante)
yd = np.zeros(T); x = np.zeros((2, 1))
for k in range(T):
    yd[k] = (C @ x).item() + sig_n * rng.standard_normal()
    x = A @ x + B * ud[k]

Um sinal gaussiano i.i.d. já é, quase sempre, persistentemente excitante de qualquer ordem razoável — na prática, um PRBS longo cumpre o mesmo papel.

Passo 2 — Matrizes de Hankel e a Partição Passado/Futuro

\[ H_L(w_d) = \begin{bmatrix} w_d(1) & \cdots & w_d(T-L+1) \\ \vdots & \ddots & \vdots \\ w_d(L) & \cdots & w_d(T) \end{bmatrix} \;=\; \begin{bmatrix} U_p \text{ ou } Y_p \\[2pt] U_f \text{ ou } Y_f \end{bmatrix} \]

Hu, Hy = hankel_mat(ud, L), hankel_mat(yd, L)
Up, Uf = Hu[:Tini, :], Hu[Tini:, :]      # "passado" (Tini linhas) / "futuro" (N linhas)
Yp, Yf = Hy[:Tini, :], Hy[Tini:, :]
nG = Hu.shape[1]                          # T - L + 1
print(f"g tem {nG} componentes — uma por coluna das matrizes de Hankel")
g tem 182 componentes — uma por coluna das matrizes de Hankel

Cada coluna de \(H_L\) é um trecho de comprimento \(L\) da trajetória \((u_d,y_d)\); Up,Yp são suas primeiras \(T_{\text{ini}}\) linhas, Uf,Yf as últimas \(N\).

Passo 3 — O Problema de Otimização

\[ \min_{g,\,\sigma_y} \; \underbrace{\|Y_fg - r\|_Q^2 + \|U_fg\|_R^2}_{\text{desempenho}} \;+\; \underbrace{\lambda_g\|g\|_2^2}_{\text{regularização}} \;+\; \underbrace{\lambda_y\|\sigma_y\|_2^2}_{\text{folga p/ ruído}} \] \[ \text{s.a.}\quad U_pg = u_{\text{ini}}, \qquad Y_pg - \sigma_y = y_{\text{ini}}, \qquad u_{\min}\leq U_fg \leq u_{\max} \]

Nota

Esta é a variante quadrática (\(\ell_2\)) da folga — mais simples de otimizar que a \(\ell_1\) mencionada em DeePC com Ruído (Coulson; Lygeros; Dörfler, 2019b). É exatamente o que deepc_exemplo.m implementa.

Passo 3 (continuação) — De Volta ao Código

A variável de decisão é \(z=[g;\,\sigma_y]\). Cada bloco do QP tem um endereço exato no código:

H1 = 2*np.block([
    [Q*(Yf.T@Yf) + R*(Uf.T@Uf) + lam_g*np.eye(nG), np.zeros((nG, Tini))],
    [np.zeros((Tini, nG)),                          lam_y*np.eye(Tini)]
])
H1 = (H1 + H1.T)/2
Aeq1 = np.block([[Up, np.zeros((Tini, Tini))],
                 [Yp, -np.eye(Tini)]])              # Up g = u_ini ; Yp g - sigma_y = y_ini
Ain1 = np.block([[ Uf, np.zeros((N, Tini))],
                 [-Uf, np.zeros((N, Tini))]])        # u_min <= Uf g <= u_max
bin1 = np.concatenate([umax*np.ones(N), -umin*np.ones(N)])

H1 carrega \(Q,R,\lambda_g,\lambda_y\); Aeq1 amarra \(g\) ao histórico recente; Ain1/bin1 impõem a restrição física de entrada.

Passo 4 — Horizonte Deslizante

from scipy.optimize import minimize

def resolve_qp(H, f, Aeq, beq, Ain, bin_, z0):
    obj  = lambda z: 0.5*z@H@z + f@z
    grad = lambda z: H@z + f
    cons = [{'type': 'eq',   'fun': lambda z: Aeq@z - beq, 'jac': lambda z: Aeq},
            {'type': 'ineq', 'fun': lambda z: bin_ - Ain@z, 'jac': lambda z: -Ain}]
    res = minimize(obj, z0, jac=grad, constraints=cons, method='SLSQP',
                    options={'maxiter': 300, 'ftol': 1e-10})
    return res.x

Nsim = 80
ref = np.concatenate([np.ones(40), 0.5*np.ones(Nsim-40+N)])   # degrau 1 -> 0.5
x = np.zeros((2, 1))
u_ini, y_ini = np.zeros(Tini), np.zeros(Tini)
y_log1, u_log1 = np.zeros(Nsim), np.zeros(Nsim)
z0 = np.zeros(nG + Tini)

for k in range(Nsim):
    r   = ref[k:k+N]
    f   = np.concatenate([-2*Q*(Yf.T@r), np.zeros(Tini)])
    beq = np.concatenate([u_ini, y_ini])
    z0  = resolve_qp(H1, f, Aeq1, beq, Ain1, bin1, z0)
    g   = z0[:nG]
    u = Uf[0, :] @ g                        # aplica só o 1º passo previsto
    y = (C@x).item() + sig_n*rng.standard_normal()
    x = A@x + B*u
    u_log1[k], y_log1[k] = u, y
    u_ini = np.concatenate([u_ini[1:], [u]])   # janela deslizante
    y_ini = np.concatenate([y_ini[1:], [y]])

u_ini,y_ini fazem o papel de estimador de estado implícito — é assim que o DeePC “sabe onde a planta está” sem nunca ter um modelo de estados.

Executando o Exemplo 1

import matplotlib.pyplot as plt
fig, axs = plt.subplots(2, 1, figsize=(9, 5.2), sharex=True)
axs[0].plot(y_log1, color=BLUE, lw=2, label="saída $y$")
axs[0].plot(ref[:Nsim], color=GRAY, lw=1.6, ls="--", label="referência $r$")
axs[0].set_ylabel("y"); axs[0].legend(loc="lower right"); axs[0].grid(alpha=.3)
axs[1].step(range(Nsim), u_log1, color=NAVY, lw=1.8, where="post", label="entrada $u$")
axs[1].axhline(umax, color=ORANGE, ls=":"); axs[1].axhline(umin, color=ORANGE, ls=":")
axs[1].set_ylabel("u"); axs[1].set_xlabel("passo $k$"); axs[1].legend(loc="lower right"); axs[1].grid(alpha=.3)
plt.tight_layout(); plt.show()
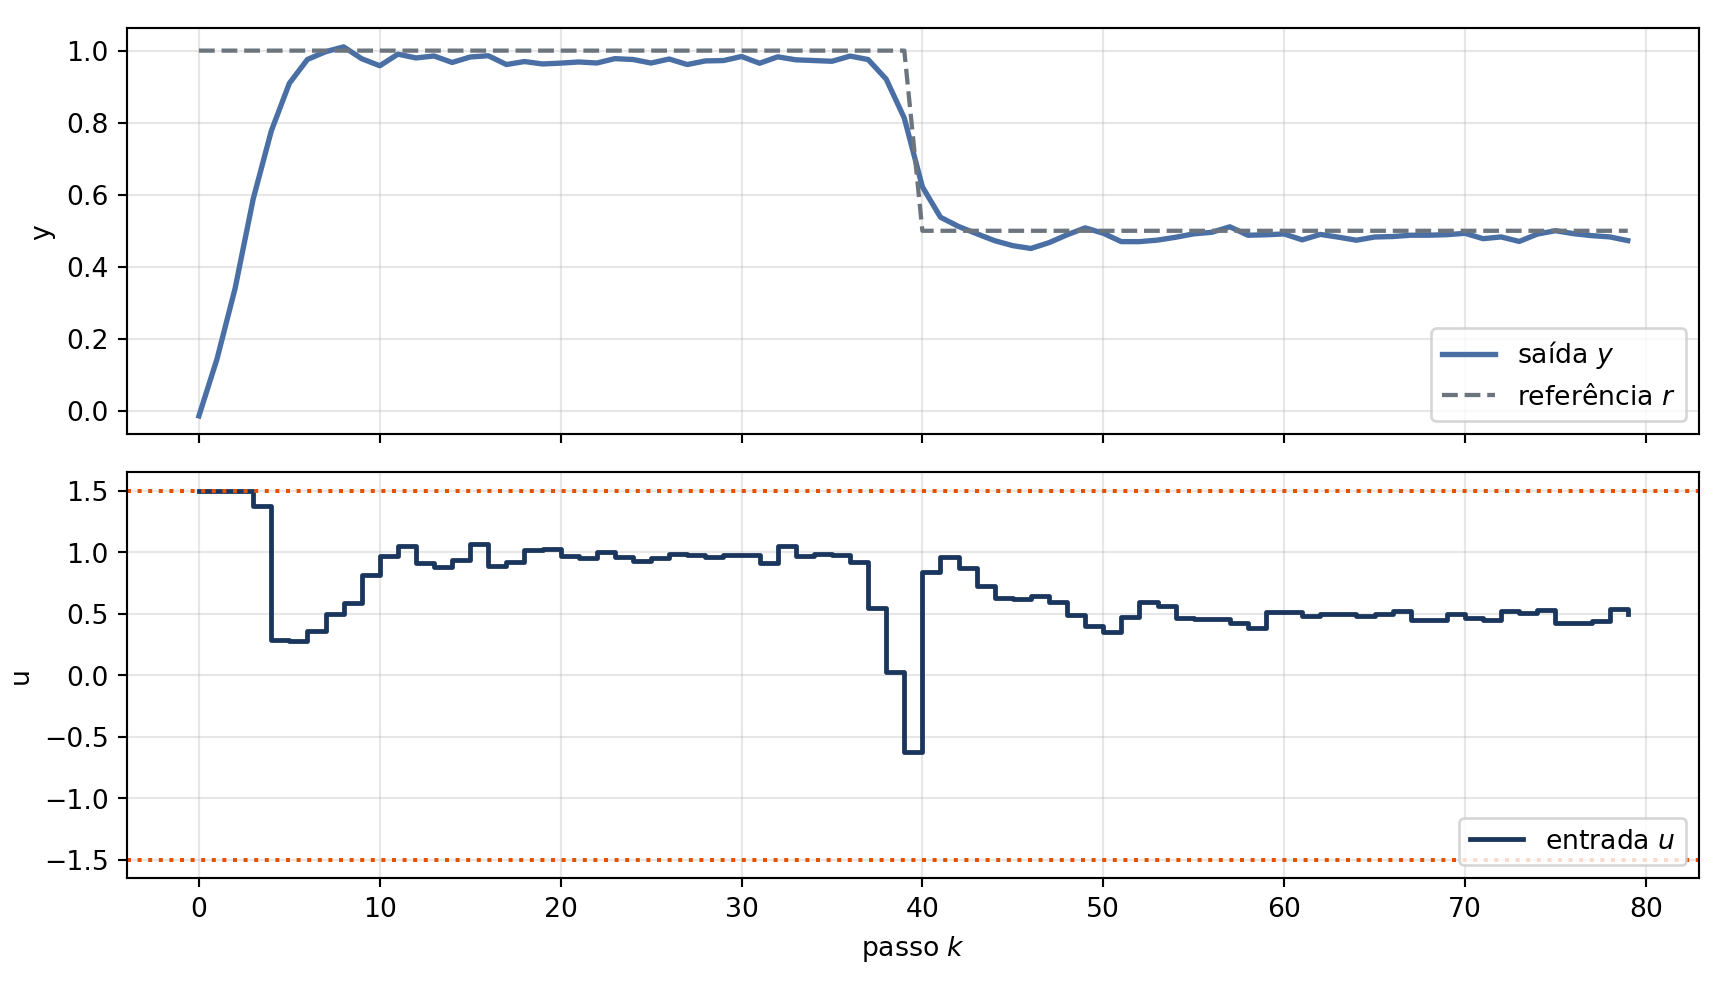
Interpretação do Exemplo 1

  • A saída converge para cada degrau da referência, mesmo sem nunca conhecer \((A,B,C)\);
  • \(u\) satura em \(u_{\max}=1{,}5\) logo no início e após a mudança de referência — a restrição está de fato ativa, não é decorativa;
  • \(n_G=182\) é maior que o necessário: há redundância nas colunas de Hankel, controlada por \(\lambda_g\|g\|_2^2\) — sem essa regularização, o problema teria infinitas soluções ótimas.

Exemplo 2 — Planta Contínua e o Desafio do Tempo Real

O que Muda Aqui

  • A planta agora é contínua, subamortecida, e discretizada por ZOH com \(T_s=2\,\)ms — muito mais realista que uma planta discreta “de fábrica”;
  • A excitação persistente é verificada formalmente (posto da Hankel), não só suposta;
  • Passamos a medir o tempo de solução do QP e compará-lo com \(T_s\) — a pergunta vira “isso cabe dentro de um período de amostragem?”.

Discretizando a Planta (ZOH sem Control Toolbox)

\[ \begin{bmatrix} A & B \\ 0 & 0 \end{bmatrix} = \exp\!\left(\begin{bmatrix} A_c & B_c \\ 0 & 0 \end{bmatrix} T_s\right) \]

from scipy.linalg import expm
rng = np.random.default_rng(1)

wn, zeta = 100.0, 0.3                          # planta subamortecida (~16 Hz)
Ac = np.array([[0, 1], [-wn**2, -2*zeta*wn]])
Bc = np.array([[0], [wn**2]])
C  = np.array([[1.0, 0.0]])
Ts = 2e-3                                       # período de amostragem [s]
n  = 2
M = np.zeros((n+1, n+1)); M[:n, :n] = Ac; M[:n, n:] = Bc
Mz = expm(M*Ts)
A, B = Mz[:n, :n], Mz[:n, n:]
sig_n = 0.01

O truque do bloco \(\exp\!\big([[A_c,B_c],[0,0]]T_s\big)\) discretiza \((A_c,B_c)\) por ZOH sem precisar da Control System Toolbox — é exatamente o que deepc_exemplo2.m faz em MATLAB.

Parâmetros e Verificando a Excitação Persistente

T, Tini, N = 300, 6, 30              # (reduzidos aqui p/ renderizar rápido; original T=500,N=40)
L = Tini + N
Q, R = 100.0, 0.05
lam_g, lam_y = 30.0, 1e5
umin, umax = -1.5, 1.5

def hankel1d(w, L):
    w = np.asarray(w).reshape(-1, 1); Tt = w.shape[0]; cols = Tt - L + 1
    Hm = np.zeros((L, cols))
    for j in range(cols): Hm[:, j] = w[j:j+L, 0]
    return Hm

ud = rng.standard_normal(T); yd = np.zeros(T); x = np.zeros((n, 1))
for k in range(T):
    yd[k] = (C@x).item() + sig_n*rng.standard_normal()
    x = A@x + B*ud[k]

rk = np.linalg.matrix_rank(hankel1d(ud, L+n))
print(f"posto(Hankel(u, L+n)) = {rk}  (esperado {L+n})")
posto(Hankel(u, L+n)) = 38  (esperado 38)
assert rk == L+n, "entrada não é persistentemente excitante"

\(u_d\) é persistentemente excitante de ordem \(L+n\) se \(H_{L+n}(u_d)\) tem posto linha completo — condição do Lema de Willems para que o Lema Fundamental se aplique (Willems et al., 2005).

Montando o QP (idêntico em estrutura ao Exemplo 1)

Hu, Hy = hankel1d(ud, L), hankel1d(yd, L)
Up, Uf = Hu[:Tini, :], Hu[Tini:, :]
Yp, Yf = Hy[:Tini, :], Hy[Tini:, :]
nG = Hu.shape[1]
print("nG =", nG, " (era 182 no Exemplo 1)")
nG = 265  (era 182 no Exemplo 1)

H2 = 2*np.block([
    [Q*(Yf.T@Yf) + R*(Uf.T@Uf) + lam_g*np.eye(nG), np.zeros((nG, Tini))],
    [np.zeros((Tini, nG)),                          lam_y*np.eye(Tini)]
])
H2 = (H2 + H2.T)/2
Aeq2 = np.block([[Up, np.zeros((Tini, Tini))], [Yp, -np.eye(Tini)]])
Ain2 = np.block([[ Uf, np.zeros((N, Tini))], [-Uf, np.zeros((N, Tini))]])
bin2 = np.concatenate([umax*np.ones(N), -umin*np.ones(N)])

Mesma receita do Exemplo 1 — só os números mudaram (\(T,T_{\text{ini}},N,Q,R, \lambda_g\) maiores, para essa planta mais rápida e mais ruidosa em relação à escala de \(T_s\)).

Malha Fechada, Agora Cronometrada

import time

Nsim = 120
t = np.arange(Nsim+N)*Ts
ref = 1.0*(t<0.06) + 0.4*((t>=0.06)&(t<0.12)) + 0.8*((t>=0.12)&(t<0.18)) - 0.5*(t>=0.18)

x = np.zeros((n, 1))
u_ini, y_ini = np.zeros(Tini), np.zeros(Tini)
y_log2, u_log2, t_qp2 = np.zeros(Nsim), np.zeros(Nsim), np.zeros(Nsim)
z0 = np.zeros(nG+Tini)

for k in range(Nsim):
    r   = ref[k:k+N]
    f   = np.concatenate([-2*Q*(Yf.T@r), np.zeros(Tini)])
    beq = np.concatenate([u_ini, y_ini])
    t0 = time.perf_counter()
    z0 = resolve_qp(H2, f, Aeq2, beq, Ain2, bin2, z0)
    t_qp2[k] = time.perf_counter() - t0
    g = z0[:nG]
    u = Uf[0, :]@g
    y = (C@x).item() + sig_n*rng.standard_normal()
    x = A@x + B*u
    u_log2[k], y_log2[k] = u, y
    u_ini = np.concatenate([u_ini[1:], [u]])
    y_ini = np.concatenate([y_ini[1:], [y]])

Resultado do Exemplo 2

fig, axs = plt.subplots(3, 1, figsize=(9, 6.6), sharex=True)
axs[0].plot(1e3*t[:Nsim], y_log2, color=BLUE, lw=1.8, label="saída $y$")
axs[0].plot(1e3*t[:Nsim], ref[:Nsim], color=GRAY, ls="--", lw=1.4, label="referência")
axs[0].set_ylabel("y"); axs[0].legend(loc="lower right"); axs[0].grid(alpha=.3)
axs[1].step(1e3*t[:Nsim], u_log2, color=NAVY, lw=1.6, where="post")
axs[1].axhline(umax, color=ORANGE, ls=":"); axs[1].axhline(umin, color=ORANGE, ls=":")
axs[1].set_ylabel("u"); axs[1].grid(alpha=.3)
axs[2].plot(1e3*t[1:Nsim], 1e3*t_qp2[1:], color=GRAY, lw=1.4, label="tempo do QP")
axs[2].axhline(1e3*Ts, color=ORANGE, ls="--", label="$T_s$")
axs[2].set_ylabel("$t_{QP}$ [ms]"); axs[2].set_xlabel("tempo [ms]")
axs[2].legend(loc="upper right"); axs[2].grid(alpha=.3)
plt.tight_layout(); plt.show()
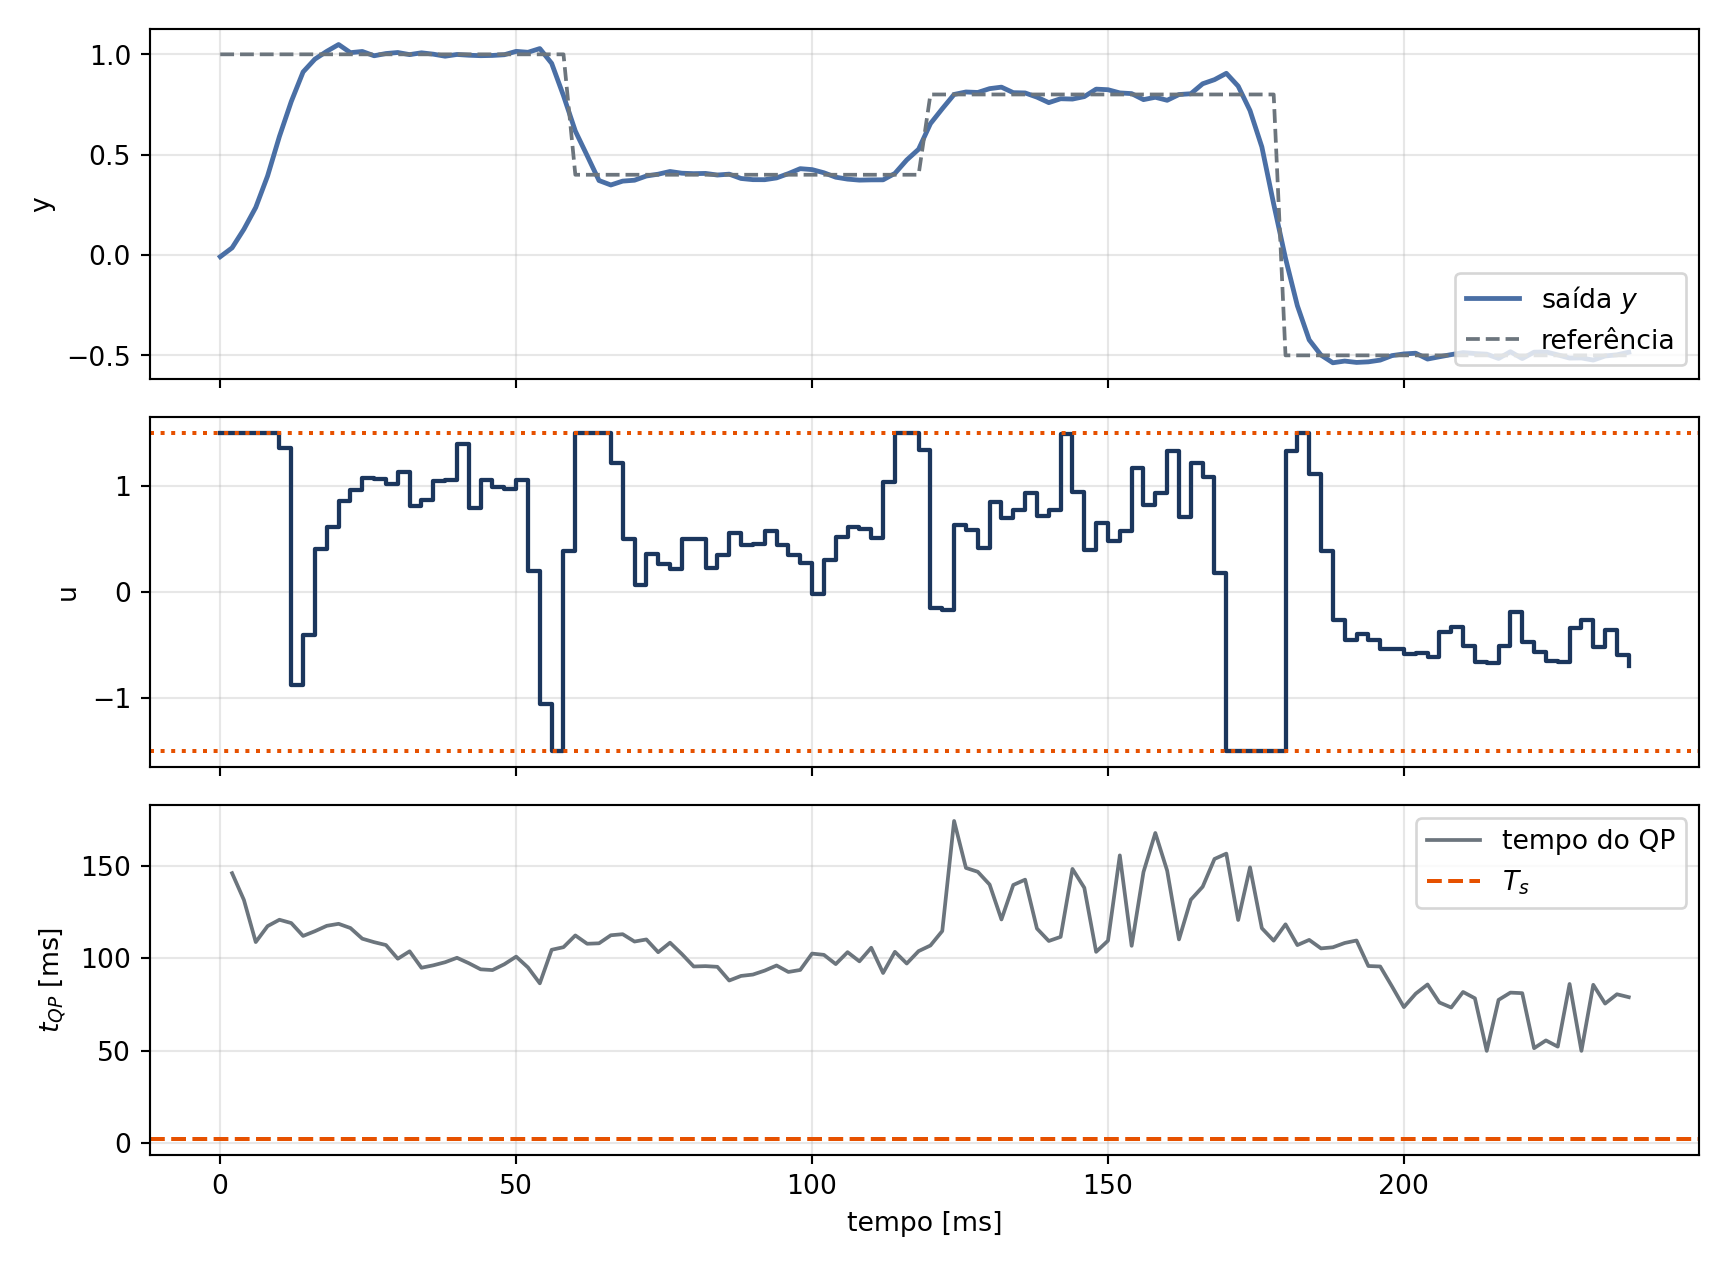
print(f"RMS do erro: {np.sqrt(np.mean((y_log2-ref[:Nsim])**2)):.4f}")
RMS do erro: 0.1992
print(f"tempo médio do QP: {1e3*t_qp2[1:].mean():.1f} ms  (Ts = {1e3*Ts:.1f} ms)")
tempo médio do QP: 106.0 ms  (Ts = 2.0 ms)

Interpretação: um Problema Real

Aviso

O QP leva, em média, mais de cem vezes o período de amostragem \(T_s\) para resolver — nesta configuração, o controlador não roda em tempo real. Isso não é um detalhe: é o obstáculo prático mais citado contra o DeePC “puro” em plantas rápidas.

O tamanho do problema (\(n_G\approx 265\) variáveis) é o principal culpado — e é exatamente o que o Exemplo 3 ataca.

Exemplo 3 — o Mesmo Problema, um QP Muito Mais Barato

A Ideia-Chave

Olhe outra vez para o custo e as restrições do QP: \(g\) nunca aparece sozinho — só através de

\[ U_pg,\quad U_fg,\quad Y_pg,\quad Y_fg \quad\text{e}\quad \|g\|_2^2. \]

Empilhe essas quatro matrizes em \(H_z=[U_p;U_f;Y_p;Y_f]\). Qualquer componente de \(g\) no núcleo de \(H_z\) não muda nenhuma dessas quatro expressões — só aumenta \(\|g\|_2^2\), que é penalizado. Logo, a solução ótima \(g^\star\) está sempre no espaço-linha de \(H_z\).

Essa é a mesma observação que justifica deepc_exemplo_v3.m: o problema tem \(n_G=T-L+1\) variáveis, mas o subespaço que de fato importa é muito menor.

Reparametrizando \(g\) por SVD

Seja \(H_z^\top = W S V^\top\) (SVD). As colunas de \(W\) associadas a valores singulares não-nulos formam uma base ortonormal do espaço-linha de \(H_z\). Escrevendo \(g=W\hat g\):

\[ \|g\|_2^2=\|\hat g\|_2^2, \qquad U_pg=(U_pW)\hat g, \qquad \text{etc.} \]

A dimensão reduzida é \(r=\operatorname{posto}(H_z)\leq 2L=2(T_{\text{ini}}+N)\) — não depende de \(T\). Colher mais dados off-line deixa \(g\) original maior, mas \(\hat g\) continua do mesmo tamanho.

Hz = np.vstack([Up, Uf, Yp, Yf])
Wfull, S, _ = np.linalg.svd(Hz.T, full_matrices=False)
r = int(np.sum(S > 1e-8*S[0]))
W = Wfull[:, :r]
print(f"redução: {Hz.shape[1]} -> {r} variáveis  (2L = {2*L})")
redução: 265 -> 72 variáveis  (2L = 72)

Bônus: Eliminando a Folga \(\sigma_y\) Analiticamente

A igualdade \(Y_pg-\sigma_y=y_{\text{ini}}\) é trivial de resolver: \(\sigma_y=Y_pg-y_{\text{ini}}\). Substituindo direto no custo \(\lambda_y\|\sigma_y\|_2^2\):

\[ \lambda_y\|Y_pg-y_{\text{ini}}\|_2^2 = \lambda_y g^\top(Y_p^\top Y_p)g \;-\;2\lambda_y\,y_{\text{ini}}^\top Y_pg \;+\; \text{cte.} \]

O termo quadrático engorda \(H\) (vira \(\lambda_y Y_p^\top Y_p\)), o termo linear engorda \(f\) — e \(\sigma_y\) desaparece como variável de decisão. Menos uma igualdade, menos \(T_{\text{ini}}\) variáveis, de graça.

O QP Reduzido, em Código

Up, Uf, Yp, Yf = Up@W, Uf@W, Yp@W, Yf@W
nG_r = Up.shape[1]

H3 = 2*(Q*(Yf.T@Yf) + R*(Uf.T@Uf) + lam_g*np.eye(nG_r) + lam_y*(Yp.T@Yp))
H3 = (H3 + H3.T)/2
Aeq3 = Up                                 # só isto: Up g = u_ini
Ain3 = np.vstack([Uf, -Uf])
bin3 = np.concatenate([umax*np.ones(N), -umin*np.ones(N)])
print(f"QP original : {nG+Tini} variáveis, {2*Tini} igualdades")
QP original : 271 variáveis, 12 igualdades
print(f"QP reduzido : {nG_r} variáveis, {Tini} igualdade(s)")
QP reduzido : 72 variáveis, 6 igualdade(s)

Compare com o Exemplo 2: Aeq2 tinha \(2T_{\text{ini}}\) linhas e \(n_G+T_{\text{ini}}\) colunas; Aeq3 é só Up — uma matriz \(T_{\text{ini}}\times r\).

Malha Fechada Reduzida (mesmos dados, mesma referência)

rng = np.random.default_rng(1)
ud_ = rng.standard_normal(T); yd_ = np.zeros(T); x = np.zeros((n, 1))
for k in range(T):                              # mesma coleta offline do Exemplo 2
    yd_[k] = (C@x).item() + sig_n*rng.standard_normal()
    x = A@x + B*ud_[k]

x = np.zeros((n, 1))
u_ini, y_ini = np.zeros(Tini), np.zeros(Tini)
y_log3, u_log3, t_qp3 = np.zeros(Nsim), np.zeros(Nsim), np.zeros(Nsim)
z0 = np.zeros(nG_r)

for k in range(Nsim):
    r_k = ref[k:k+N]
    f   = -2*(Q*(Yf.T@r_k) + lam_y*(Yp.T@y_ini))
    beq = u_ini
    t0 = time.perf_counter()
    g = resolve_qp(H3, f, Aeq3, beq, Ain3, bin3, z0)
    t_qp3[k] = time.perf_counter() - t0
    z0 = g
    u = Uf[0, :]@g
    y = (C@x).item() + sig_n*rng.standard_normal()
    x = A@x + B*u
    u_log3[k], y_log3[k] = u, y
    u_ini = np.concatenate([u_ini[1:], [u]])
    y_ini = np.concatenate([y_ini[1:], [y]])

Resultado do Exemplo 3

fig, axs = plt.subplots(3, 1, figsize=(9, 6.6), sharex=True)
axs[0].plot(1e3*t[:Nsim], y_log3, color=BLUE, lw=1.8, label="saída $y$")
[<matplotlib.lines.Line2D object at 0x13b508410>]
axs[0].plot(1e3*t[:Nsim], ref[:Nsim], color=GRAY, ls="--", lw=1.4, label="referência")
[<matplotlib.lines.Line2D object at 0x13b508550>]
axs[0].set_ylabel("y"); axs[0].legend(loc="lower right"); axs[0].grid(alpha=.3)
Text(0, 0.5, 'y')
<matplotlib.legend.Legend object at 0x13b508690>
axs[1].step(1e3*t[:Nsim], u_log3, color=NAVY, lw=1.6, where="post")
[<matplotlib.lines.Line2D object at 0x13b509bd0>]
axs[1].axhline(umax, color=ORANGE, ls=":"); axs[1].axhline(umin, color=ORANGE, ls=":")
<matplotlib.lines.Line2D object at 0x13b509d10>
<matplotlib.lines.Line2D object at 0x13b509e50>
axs[1].set_ylabel("u"); axs[1].grid(alpha=.3)
Text(0, 0.5, 'u')
axs[2].plot(1e3*t[1:Nsim], 1e3*t_qp3[1:], color=GREEN, lw=1.4, label="tempo do QP (reduzido)")
[<matplotlib.lines.Line2D object at 0x13b3ee350>]
axs[2].axhline(1e3*Ts, color=ORANGE, ls="--", label="$T_s$")
<matplotlib.lines.Line2D object at 0x13b3ee990>
axs[2].set_ylabel("$t_{QP}$ [ms]"); axs[2].set_xlabel("tempo [ms]")
Text(0, 0.5, '$t_{QP}$ [ms]')
Text(0.5, 0, 'tempo [ms]')
axs[2].legend(loc="upper right"); axs[2].grid(alpha=.3)
<matplotlib.legend.Legend object at 0x13b3eead0>
plt.tight_layout(); plt.show()

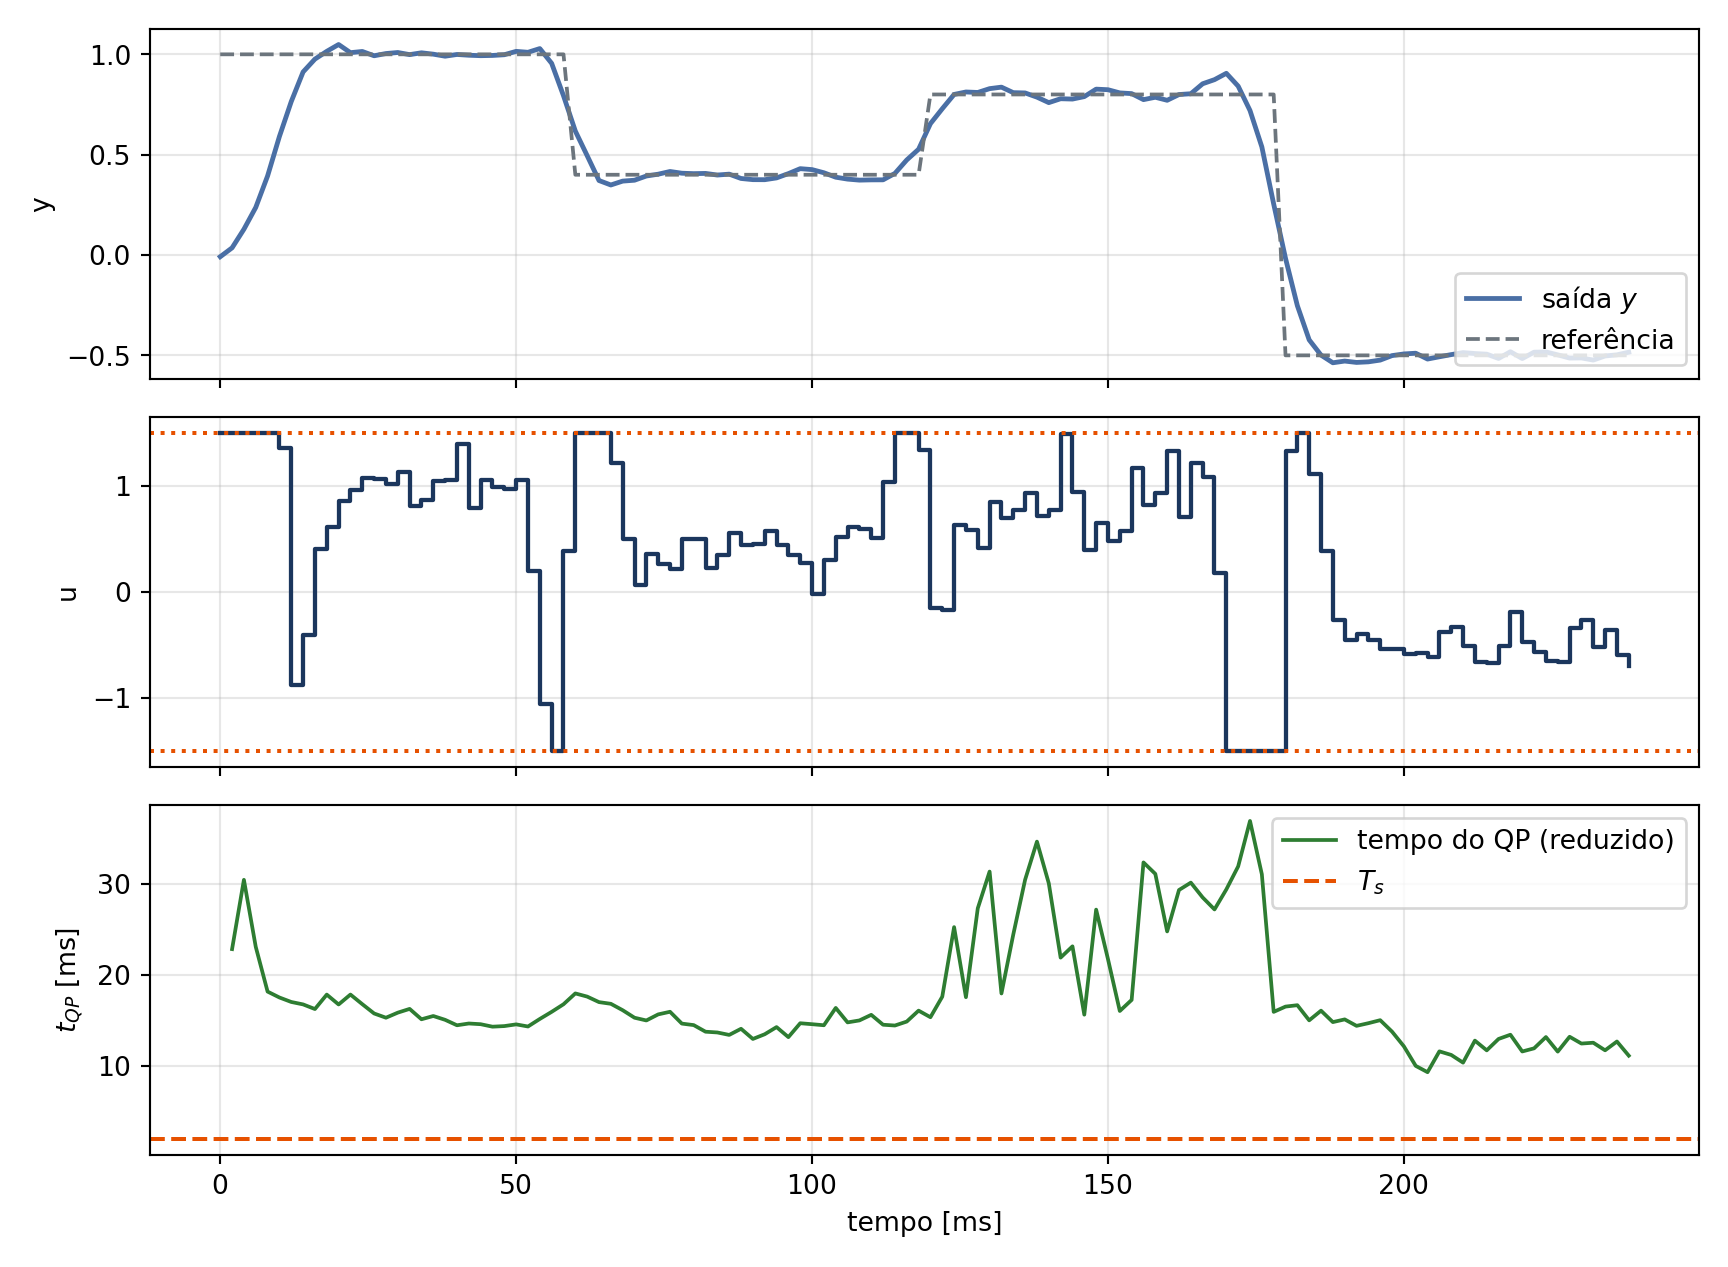
print(f"RMS do erro: {np.sqrt(np.mean((y_log3-ref[:Nsim])**2)):.4f}  (Exemplo 2: confira o slide anterior)")
RMS do erro: 0.1992  (Exemplo 2: confira o slide anterior)

Antes vs. Depois, Lado a Lado

fig, axs = plt.subplots(1, 2, figsize=(8, 3.6))
b1 = axs[0].bar(["QP original", "QP reduzido"], [nG+Tini, nG_r], color=[GRAY, GREEN])
axs[0].set_ylabel("variáveis de decisão"); axs[0].bar_label(b1)
Text(0, 0.5, 'variáveis de decisão')
[Text(0, 0, '271'), Text(0, 0, '72')]
b2 = axs[1].bar(["QP original", "QP reduzido"],
                 [1e3*t_qp2[1:].mean(), 1e3*t_qp3[1:].mean()], color=[GRAY, GREEN])
axs[1].set_ylabel("tempo médio do QP [ms]")
Text(0, 0.5, 'tempo médio do QP [ms]')
axs[1].axhline(1e3*Ts, color=ORANGE, ls="--", lw=1.2)
<matplotlib.lines.Line2D object at 0x13b6287d0>
axs[1].bar_label(b2, fmt="%.1f")
[Text(0, 0, '106.0'), Text(0, 0, '17.6')]
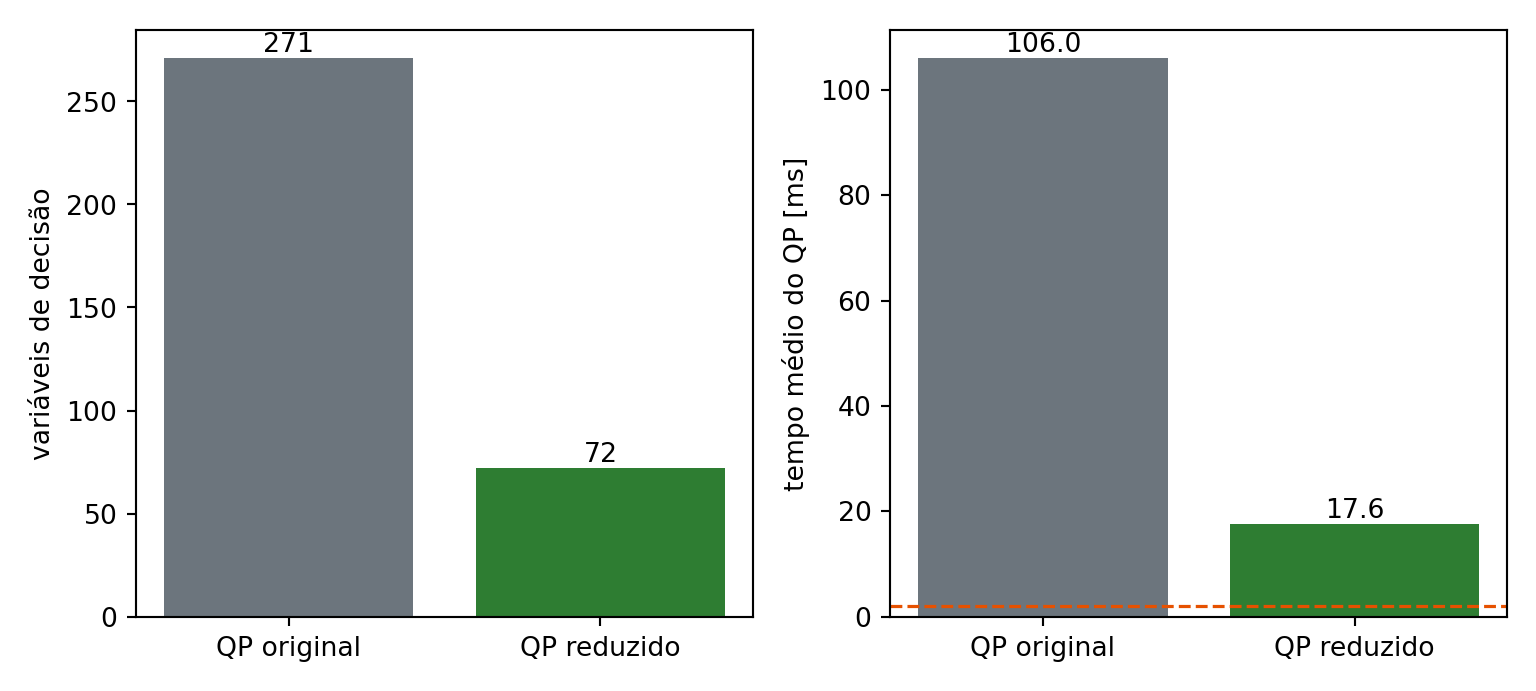
plt.tight_layout(); plt.show()

Interpretação do Exemplo 3

  • O erro RMS é (numericamente) o mesmo dos Exemplos 2 — a redução por SVD não perde informação, como a álgebra do slide anterior já garantia;
  • O QP fica mais de 10× mais rápido só reduzindo variáveis, sem trocar de solver;
  • Ainda assim, \(t_{QP}\) segue acima de \(T_s=2\,\)ms aqui — porque scipy+SLSQP é um solver genérico. Um quadprog/OSQP/qpOASES dedicado, como o MATLAB usa, fecharia boa parte dessa distância;
  • Truncar a base (\(r_{\text{trunc}}<r\), opção do deepc_exemplo_v3.m) reduz ainda mais o QP e funciona como denoising — a mesma ideia de regularização de DeePC com Ruído, agora vista pelo ângulo da compressão de \(g\).

Síntese

Os Três Exemplos, Lado a Lado

Exemplo 1 Exemplo 2 Exemplo 3
Pergunta Como o DeePC funciona? Isso roda em tempo real? Como fazer rodar mais rápido?
Planta 2ª ordem discreta 2ª ordem contínua, \(T_s=2\,\)ms a mesma do Exemplo 2
Variável de decisão \(z=[g;\sigma_y]\), \(n_G+T_{\text{ini}}\approx 186\) idem, \(\approx 271\) \(\hat g\), \(r=2L\approx 72\)
O que aprendemos receita completa: dados → Hankel → QP → horizonte deslizante \(t_{QP}\) pode violar \(T_s\): viabilidade não é automática mesma solução, QP muito mais barato via SVD

O Que Levar Desta Aula

  • O DeePC não é mágica: é um QP cujas matrizes vêm de dados brutos em vez de \((A,B,C,D)\) — cada peça do QP tem um nome e um papel;
  • “Sem modelo” não significa “sem parâmetros de projeto”: \(T_{\text{ini}},N, Q,R,\lambda_g,\lambda_y\) ainda precisam ser escolhidos com critério;
  • Viabilidade em tempo real é uma pergunta separada de correção — e, como no Exemplo 2, pode falhar mesmo com a formulação certa;
  • Redução de dimensão (Exemplo 3) é “de graça” matematicamente, porque o problema só depende de \(g\) através de um número pequeno de combinações lineares.

Ver Também

  • DeePC — Introdução — Lema de Willems e a formulação mínima sem ruído;
  • DeePC com Ruído — de onde vem a regularização usada em todos os três exemplos de hoje;
  • Nota — DeePC — texto de referência completo, com todas as citações;
  • Os três scripts originais em MATLAB: deepc_exemplo.m, deepc_exemplo2.m, deepc_exemplo_v3.m.

Referências

COULSON, Jeremy; LYGEROS, John; DÖRFLER, Florian. Data-Enabled Predictive Control: In the Shallows of the DeePC. In: IEEE, a2019.
COULSON, Jeremy; LYGEROS, John; DÖRFLER, Florian. Regularized and Distributionally Robust Data-Enabled Predictive Control. In: IEEE, b2019.
HUANG, Linbin et al. Quadratic Regularization of Data-Enabled Predictive Control: Theory and Application to Power Converter Experiments. IFAC-PapersOnLine, v. 54, n. 7, p. 192–197, 2021.
WILLEMS, Jan C. et al. A Note on Persistency of Excitation. Systems & Control Letters, v. 54, n. 4, p. 325–329, 2005.

Encerramento

Prof. Dr. Raphael Teixeira

Universidade Federal do Pará

raphaelbt@ufpa.br